Co oznacza sprzedaż zanonimizowanych danych firmy?
Oznacza, że kupujący dostaje treść pracy firmy, ale żadnej z osób, które w niej uczestniczą. Laboratorium AI dowiaduje się, jak zespół rozpatruje reklamację, ustala zakres projektu albo naprawia błąd. Nigdy nie dowiaduje się, kto napisał wiadomość, jakiego klienta dotyczyła ani jak się z kimkolwiek skontaktować.
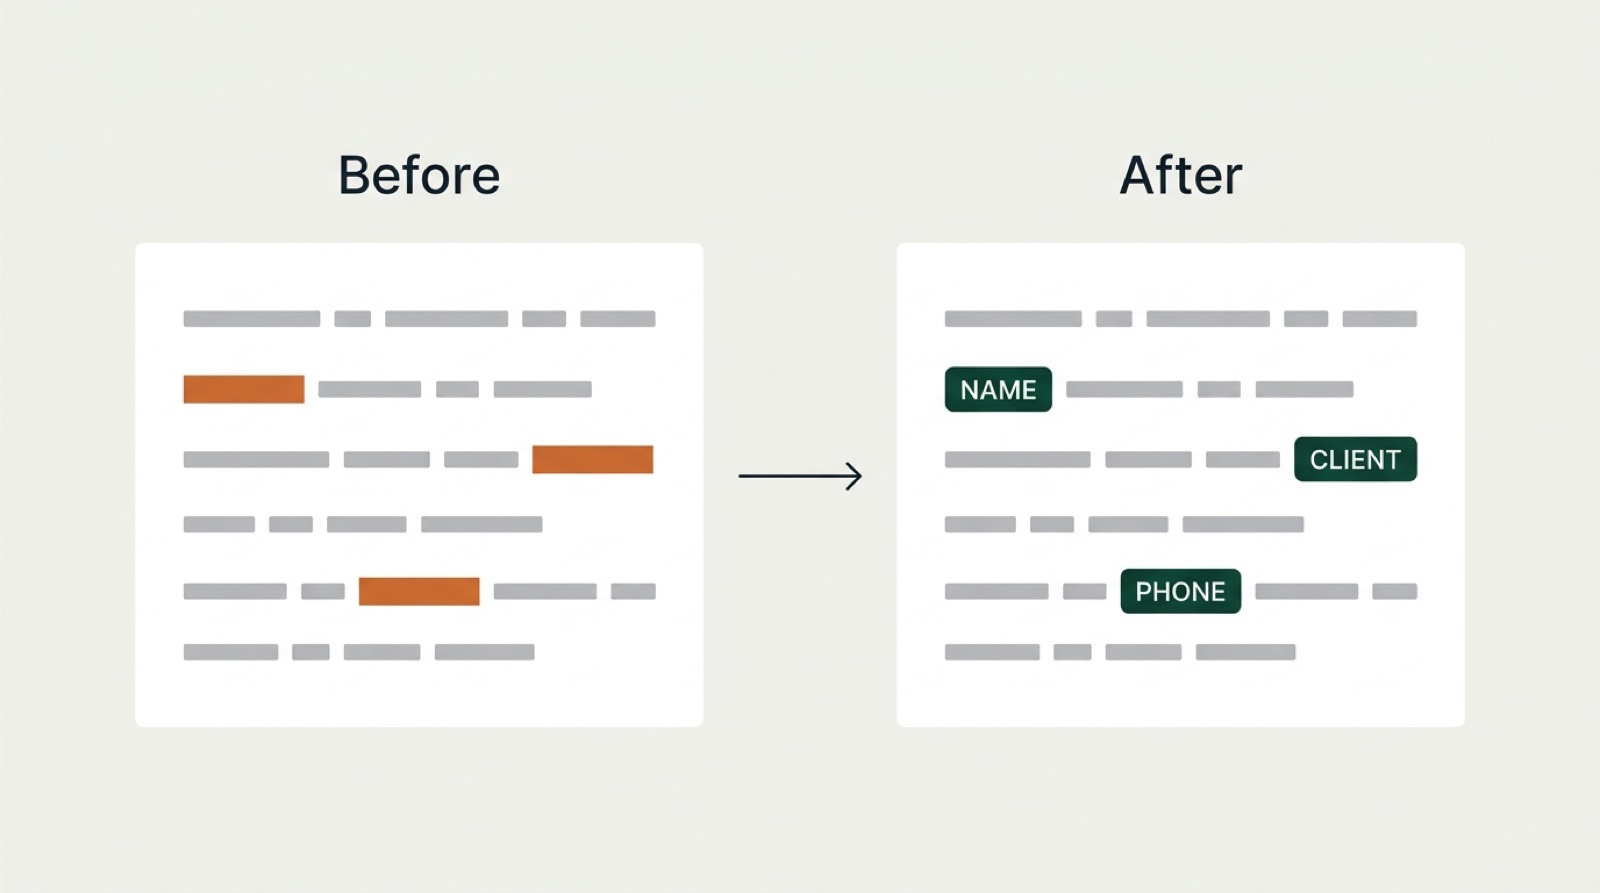
Kupujemy takie dane od firm zatrudniających od około 10 osób: wiadomości ze Slacka i Teams, e-maile, dokumenty, zgłoszenia, wpisy w CRM, kod i procedury. Oczyszczamy je, a potem licencjonujemy laboratoriom AI, które trenują i testują modele. Oryginały zostają w firmie i można z nich dalej korzystać. Licencjonowana jest kopia.
Nasza deklaracja jest prosta: dostarczamy dane w pełni zanonimizowane. Taka deklaracja coś znaczy tylko wtedy, gdy stoją za nią konkretne kroki. Ta strona je wymienia, a także otwarcie mówi, w jakim zakresie RODO nadal obowiązuje firmę.
Czym są dane zanonimizowane w rozumieniu RODO?
Dane zanonimizowane to informacje, które nie dotyczą już zidentyfikowanej ani możliwej do zidentyfikowania osoby. RODO się do nich nie stosuje. Zasada ta wynika z motywu 26 RODO, zgodnie z którym zasady ochrony danych nie powinny mieć zastosowania do danych zanonimizowanych w taki sposób, że osoby nie można już zidentyfikować. W anglojęzycznych dokumentach spotyka się zapis anonymised albo, w pisowni amerykańskiej, anonymized.
Test jest rygorystyczny. Motyw 26 każe zapytać, czy ktokolwiek mógłby zidentyfikować osobę przy użyciu wszystkich rozsądnie prawdopodobnych sposobów, przez firmę lub przez kogoś innego. Jako czynniki wymienia koszt, czas i dostępną technologię. Usunięcie nazwiska nie wystarczy, jeśli reszta zapisu nadal zdradza, o kogo chodzi.
Anonimizacja
Anonimizacja to proces trwałego przekształcenia danych osobowych w dane zanonimizowane. Po nim nikt, ani my, ani firma, nie jest w stanie powiązać zapisu z konkretną osobą. Wynik znajduje się poza zakresem RODO.
Pseudonimizacja
Pseudonimizację definiuje art. 4 pkt 5 RODO. Polega ona na takim przetworzeniu danych, by nie można ich było przypisać konkretnej osobie bez użycia dodatkowych informacji, które są przechowywane osobno i odpowiednio chronione. Zamiana "Anna de Vries" na "Pracownik 0042" przy zachowaniu listy, która przypisuje jedno do drugiego, to pseudonimizacja.
Motyw 26 jednoznacznie stwierdza, że dane spseudonimizowane nadal są danymi osobowymi, ponieważ przy użyciu tych dodatkowych informacji można je ponownie powiązać z osobą. Dlatego nie przechowujemy żadnej listy, tabeli przypisań ani jakiegokolwiek innego mapowania.
Anonimizacja a pseudonimizacja: na czym polega różnica?
Różnica tkwi w kluczu. Dane spseudonimizowane mają go gdzieś. Dane zanonimizowane nie mają go nigdzie. Wszystko inne z tego wynika.
| Co zostaje | Czy można je powiązać z osobą? | Status w RODO | |
|---|---|---|---|
| Dane surowe | Wszystko: imiona i nazwiska, e-maile, numery telefonów, nazwy klientów, numery IBAN, adresy | Tak, bo wprost wskazują osoby | Dane osobowe |
| Dane spseudonimizowane | Tekst, w którym nazwiska zamieniono na kody lub tokeny | Tak, może to zrobić każdy, kto ma klucz | Nadal dane osobowe (motyw 26, art. 4 pkt 5) |
| Dane w pełni zanonimizowane (to, co dostarczamy) | Tekst, w którym identyfikatory zastąpiono znacznikami typu, takimi jak [OSOBA] czy [KLIENT] | Nie. Nikt nie przechowuje klucza, a zdradzający kontekst jest usuwany | Poza zakresem RODO, gdy nikt nie jest w stanie rozsądnie zidentyfikować osoby (motyw 26) |
Przykład z praktyki: w pliku spseudonimizowanym "Pracownik 0042" pojawia się w 300 wiadomościach, więc czytelnik może śledzić jedną osobę w całym archiwum. W naszych plikach każde nazwisko staje się tym samym znacznikiem, [OSOBA]. Rozmowa nadal ma sens, ale nie ma nitki, za którą można by pociągnąć.
Dane spseudonimizowane mają gdzieś klucz. Dane w pełni zanonimizowane nie mają klucza nigdzie.
Co usuwamy, zanim dane zostaną sprzedane?
Usuwamy każdy bezpośredni identyfikator, a następnie kontekst, który mógłby wskazać konkretną osobę. Pierwsza część jest mechaniczna. Druga wymaga oceny.
- Imiona i nazwiska pracowników, klientów, dostawców i osób kontaktowych, łącznie ze zdrobnieniami i @wzmiankami
- Adresy e-mail, numery telefonów i adresy pocztowe
- Nazwy firm klientów i dostawców
- Numery rachunków bankowych i IBAN oraz numery faktur i umów, które prowadzą do konta
- Numery klientów, identyfikatory użytkowników, numery rejestracyjne pojazdów i inne numery identyfikujące
- Podpisy, stopki e-maili i dane z profili
- Kontekst wskazujący jedną osobę, na przykład "nasz jedyny prawnik podatkowy w Leeds" albo data czyjegoś zwolnienia lekarskiego
Każdy element zastępujemy znacznikiem jego typu, dzięki czemu tekst zachowuje swój kształt. Poniższe przykłady pokazują, jak wygląda to na codziennych zapisach.
- Slack, #sprzedaz
Anouk, możesz przed piątkiem zadzwonić do Pietera Verbeeka z Brightwater Foods? Numer bezpośredni: +31 6 12345678. Chcą zeszłorocznej ceny.
- Zgłoszenie w Jirze
Eksport faktur nie działa dla Kroonstad Logistics. Zgłosił Tom de Wit, kontakt: l.jansen@kroonstad.example. Odtworzono na stagingu.
- E-mail
Dzień dobry Marieke, prosimy o wpłatę kaucji na NL00 BANK 0123 4567 89 do poniedziałku. Klucze są w naszym biurze w Utrechcie. Pozdrawiam, Joost Bakker
- Notatka w CRM
Spotkanie z Sanne Vos z Hollander Bouw w Zwolle. Chce oferty na 40 stanowisk. Kontakt w dalszej sprawie: sanne@hollanderbouw.example.
Każdy znacznik jest ogólny. Nie istnieje żaden klucz prowadzący do oryginału.
Najtrudniejszy jest kontekst. "Nasz dyrektor finansowy" w każdej firmie oznacza jedną osobę. To samo może zrobić stanowisko w trzyosobowym zespole, miejscowość w połączeniu z rzadkim zdarzeniem albo podana wysokość wynagrodzenia. Jeśli szczegół niewiele wnosi dla kupującego, usuwamy go. Jeśli ma znaczenie, uogólniamy go, na przykład "członek kadry kierowniczej" zamiast stanowiska, które zajmuje jedna osoba.
Co zostaje całkowicie wyłączone ze zbioru danych?
Niektóre dane nigdy nie wchodzą do sprzedaży, oczyszczone czy nie. Ryzyko jest zbyt duże albo dane nie należą do firmy.
- Dane o zdrowiu, w tym zwolnienia lekarskie i informacje medyczne w aktach kadrowych
- Krajowe numery identyfikacyjne, takie jak PESEL, numery paszportów i podobne identyfikatory urzędowe
- Inne szczególne kategorie danych w rozumieniu RODO, takie jak wyznanie, przynależność do związków zawodowych, orientacja seksualna i dane biometryczne
- Dane klientów przetwarzane w roli podmiotu przetwarzającego, na przykład płace prowadzone dla klientów lub dane hostowane dla klientów
- Materiały objęte tajemnicą zawodową lub poufne dane klientów, chyba że da się je w pełni oczyścić
Zawody objęte obowiązkiem zachowania tajemnicy wymagają szczególnej ostrożności. Strona o sprzedaży danych kancelarii prawnej pokazuje, co wchodzi do sprzedaży, a co zostaje wyłączone. Szablony, procesy i wewnętrzne know-how zwykle zachowują wartość bez jakichkolwiek danych klientów.
Jak anonimizuje się dane ze Slacka, Teams lub poczty e-mail?
Łączymy automatyczne wykrywanie z weryfikacją przez ludzi. Oprogramowanie wyszukuje na dużą skalę oczywiste wzorce: imiona i nazwiska, adresy e-mail, numery telefonów, numery IBAN, kody pocztowe. Następnie ludzie czytają próbki wyniku i szukają tego, co umyka oprogramowaniu, na przykład kontekstu wskazującego jedną osobę.
Slack i Teams
W danych z czatu tożsamość kryje się w większej liczbie miejsc niż sama treść wiadomości. Nazwy wyświetlane, @wzmianki, identyfikatory użytkowników, nazwy kanałów takie jak #client-brightwater i nazwy udostępnionych plików są traktowane tak samo. Emoji i znaczniki czasu zostają, bo pokazują przepływ pracy, ale dokładne godziny można uogólnić tam, gdzie pozwalałyby kogoś zidentyfikować. Strona o sprzedaży danych ze Slacka, Teams i Jiry wyjaśnia, czego laboratoria uczą się z każdego narzędzia.
Poczta e-mail ukrywa identyfikatory w nagłówkach, podpisach, stopkach prawnych i długich łańcuchach cytowanych odpowiedzi. Oczyszczamy pola Od, Do i DW, usuwamy podpisy i stopki, a każdą cytowaną odpowiedź traktujemy jako tekst do ponownego oczyszczenia. Nazwisko usunięte z początku wątku nie może przetrwać w cytowanej wiadomości na jego końcu.
Zgłoszenia, CRM i dokumenty
Zgłoszenia i notatki w CRM są pełne nazw klientów, numerów kont i danych kontaktowych. Dokumenty dodają nagłówki, pola autora i metadane plików. Oczyszczamy zarówno widoczny tekst, jak i metadane, bo pole autora w pliku może wskazać osobę równie skutecznie jak jego pierwsza linijka.
- Pisemnie ustalamy, które źródła wchodzą do sprzedaży, a które nie.
- Automatyczne wykrywanie oznacza identyfikatory w całym zbiorze.
- Oznaczone elementy są zastępowane znacznikami typu, takimi jak [OSOBA] czy [IBAN].
- Weryfikatorzy czytają próbki i szukają zdradzającego kontekstu.
- Wszystko, co znajdą, jest poprawiane w całym zbiorze, a nie tylko w próbce.
Czy dane zanonimizowane można ponownie zidentyfikować?
Źle zanonimizowane dane tak. Dobrze zanonimizowane nie powinny. Grupa Robocza Art. 29, w której współpracowały unijne organy ochrony danych, opisała w opinii 05/2014 w sprawie technik anonimizacji trzy sposoby, w jakie anonimizacja zawodzi: wyodrębnienie jednej osoby, powiązanie zapisów dotyczących tej samej osoby oraz wnioskowanie o osobie na podstawie innych szczegółów.
Nasze kroki odpowiadają tym trzem ryzykom. Ogólne znaczniki uniemożliwiają powiązanie, bo każde nazwisko wygląda tak samo. Usunięcie zdradzającego kontekstu uniemożliwia wyodrębnienie. Wyłączenie danych o zdrowiu i innych szczególnych kategorii danych ogranicza to, co ktokolwiek mógłby wywnioskować.
Najważniejszy jest klucz. Gdyby istniała lista łącząca znaczniki z prawdziwymi nazwiskami, każdy, kto by ją zdobył, mógłby cofnąć całą pracę. Dlatego nigdy jej nie tworzymy. Nikt jej nie ma: ani my, ani firma, ani kupujący. Po skasowaniu oryginałów nie zostaje nic, z czym można by cokolwiek porównać.
Żadna metoda nie jest doskonała i wolimy to powiedzieć otwarcie. Dlatego wynik sprawdza człowiek, dlatego firma sprawdza próbkę i dlatego licencji udzielamy wyłącznie laboratoriom AI i zespołom badawczym na podstawie umowy. Nic nie jest publikowane.
Co sprawdza firma, zanim cokolwiek zostanie sprzedane?
Firma sprawdza oczyszczoną próbkę i ją zatwierdza. Bez tego zatwierdzenia nic nie zostaje sprzedane. Poniższe kroki to końcowa część opisu, jak przebiega sprzedaż, od przekazania danych do wypłaty.
- Bezpieczne przekazanie: szyfrowany dostęp tylko do odczytu do zatwierdzonych źródeł, od pierwszego dnia na podstawie NDA.
- Oczyszczanie: podczas przetwarzania usuwamy nazwiska, dane klientów i inne identyfikatory.
- Zatwierdzenie: firma czyta oczyszczoną próbkę. Jeśli coś zauważy, poprawiamy to w całym zbiorze, a firma sprawdza ponownie.
- Skasowanie oryginałów: po zakończeniu przetwarzania kasujemy naszą kopię oryginałów. Oryginały firmy zostają tam, gdzie były.
- Wypłata: pieniądze trafiają na konto w ciągu 7 dni od pozytywnej weryfikacji danych.
Kupujący widzą tylko zanonimizowane próbki. Pełny pakiet otrzymują dopiero po zapłacie. Nigdy nie udzielamy licencji konkurencji.
Anonimizacja nie odbiera danym wartości. Laboratoria chcą sposobu rozumowania, wymiany zdań i decyzji, a nie nazwisk. Dane firmy mogą przynieść €10K–€600K, a większe lub specjalistyczne zbiory danych nawet kilkaset tysięcy euro. Strona o tym, dlaczego dane firmy są warte pieniądze, wyjaśnia, co wpływa na cenę.
Czy trzeba poinformować pracowników?
Tak. Gotowy zbiór danych jest zanonimizowany, ale jego przygotowanie już nie. By oczyścić wiadomości, ktoś musi je przetwarzać, gdy wciąż zawierają nazwiska. Ten etap jest przetwarzaniem danych osobowych w rozumieniu RODO i to samo stwierdza wspomniana wyżej opinia 05/2014: anonimizacja sama w sobie jest dalszym przetwarzaniem.
Dane zanonimizowane są poza zakresem RODO. Ich przygotowanie już nie.
W praktyce oznacza to po stronie firmy trzy rzeczy. Potrzebna jest udokumentowana ocena: test zgodności nowego celu, zwykle ocena prawnie uzasadnionego interesu, a często także ocena skutków dla ochrony danych (DPIA). Potrzebna jest przejrzystość: zaktualizowana klauzula informacyjna, która informuje pracowników i kontakty, że zdeidentyfikowane kopie mogą być licencjonowane do trenowania AI, wraz z prostym sposobem wniesienia sprzeciwu. A jeśli w firmie działa rada pracowników, warto zaangażować ją wcześnie.
Poradnik o tym, czy sprzedaż danych firmy jest zgodna z RODO, omawia każdy krok i zawiera listę kontrolną. Zakres i warunki, które z Państwem podpisujemy, stanowią też dokumentację do własnych akt firmy.
Pytania
Czy dane zanonimizowane nadal są danymi osobowymi w rozumieniu RODO?
Nie, jeśli są naprawdę anonimowe. Motyw 26 RODO stanowi, że przepisy nie mają zastosowania do danych, w których osoby nie można już zidentyfikować żadnym rozsądnie prawdopodobnym sposobem. Dane spseudonimizowane, do których wciąż istnieje klucz, pozostają danymi osobowymi.
Czym różnią się terminy anonymised i anonymized w anglojęzycznych umowach?
Niczym. Anonymised to pisownia brytyjska, a anonymized amerykańska. Oba terminy oznaczają dane, których nie da się już powiązać z osobą, czyli dane zanonimizowane.
Czy przechowujecie klucz, by w razie potrzeby odtworzyć dane?
Nie. Zastępujemy identyfikatory ogólnymi znacznikami, takimi jak [OSOBA], i nigdy nie tworzymy listy przypisującej znaczniki do osób. Przechowywanie takiej listy oznaczałoby, że dane są spseudonimizowane, a więc nadal są danymi osobowymi.
Czy mogę zobaczyć, jak wyglądają moje dane po oczyszczeniu?
Tak. Przed sprzedażą sprawdzają Państwo oczyszczoną próbkę i bez Państwa zatwierdzenia nic nie idzie dalej. Jeśli coś Państwo zauważą, poprawiamy to w całym zbiorze.
Co dzieje się z oryginalnymi danymi?
Zostają w firmie i można z nich dalej korzystać, bo licencjonowana jest kopia. Nasza kopia oryginałów jest kasowana po zakończeniu przetwarzania.
Czy dane medyczne lub kadrowe są kiedykolwiek uwzględniane?
Dane o zdrowiu, krajowe numery identyfikacyjne i inne szczególne kategorie danych są całkowicie wyłączone. Akta kadrowe zawierające takie informacje są wyłączane, a nie oczyszczane i sprzedawane.
Czy anonimizacja sprawia, że dane tracą wartość dla laboratoriów AI?
Nie. Laboratoria trenują modele na tym, jak wykonuje się pracę: na pytaniach, rozumowaniu i decyzjach. Nazwiska i numery telefonów nic do tego nie wnoszą, więc ich usunięcie odbiera bardzo niewiele wartości.
Kto kupuje zanonimizowane dane?
Laboratoria AI i zespoły badawcze, które trenują i testują modele, na podstawie umowy. Nigdy nie udzielamy licencji konkurencji i nic nie jest publikowane.
To informacje ogólne, a nie porada prawna.