Wat betekent het om geanonimiseerde bedrijfsdata te verkopen?
Het betekent dat een koper de inhoud van uw werk krijgt en niets van de mensen erin. Een AI-lab leert hoe uw team een klacht afhandelt, een project afbakent of een bug oplost. Het leert nooit wie het bericht schreef, over welke klant het ging of hoe iemand te bereiken is.
Wij kopen dat soort data van bedrijven vanaf ongeveer 10 mensen: berichten uit Slack en Teams, e-mail, documenten, tickets, CRM-gegevens, code en procedures. We schonen de data op en geven haar daarna in licentie aan AI-labs die modellen trainen en testen. U houdt uw originelen en blijft ze gebruiken. U geeft een kopie in licentie.
Onze bewering is eenvoudig: wat wij leveren is volledig geanonimiseerd. Die bewering betekent alleen iets als er concrete stappen achter zitten. Deze pagina noemt ze, en zegt ook eerlijk waar de AVG nog wel voor u geldt.
Wat is geanonimiseerde data onder de AVG?
Geanonimiseerde data is informatie die niet langer betrekking heeft op een geïdentificeerde of identificeerbare persoon. De AVG is er niet op van toepassing. Die regel staat in overweging 26 van de AVG, die zegt dat de beginselen van gegevensbescherming niet gelden voor gegevens die zo anoniem zijn gemaakt dat de persoon niet meer identificeerbaar is. In Engelstalige bronnen heet dit anonymised data, of in Amerikaanse spelling anonymized data.
De toets is streng. Overweging 26 vraagt of iemand een persoon zou kunnen identificeren met alle middelen waarvan redelijkerwijs te verwachten is dat ze worden gebruikt, door u of door een ander. Kosten, tijd en beschikbare technologie worden als factoren genoemd. Een naam weghalen is niet genoeg als de rest van het gegeven de persoon nog verraadt.
Anonimiseren
Anonimiseren is het proces waarmee persoonsgegevens voorgoed worden omgezet in geanonimiseerde gegevens. Niemand, ook wij niet en ook u niet, kan een gegeven daarna nog herleiden tot een persoon. Het resultaat valt buiten de AVG.
Pseudonimiseren
Pseudonimisering is gedefinieerd in artikel 4, punt 5, van de AVG. Het betekent dat gegevens zo worden verwerkt dat ze zonder aanvullende informatie niet meer aan een persoon kunnen worden gekoppeld, waarbij die informatie apart wordt bewaard en beschermd. "Anna de Vries" vervangen door "Medewerker 0042" en de lijst bewaren die het een aan het ander koppelt, is pseudonimiseren.
Overweging 26 is duidelijk: gepseudonimiseerde gegevens zijn nog steeds persoonsgegevens, omdat ze met die extra informatie weer te koppelen zijn. Daarom bewaren wij geen lijst, geen opzoektabel en geen koppeling van welke soort dan ook.
Anonimiseren of pseudonimiseren: wat is het verschil?
Het verschil is de sleutel. Gepseudonimiseerde data heeft er ergens een. Geanonimiseerde data heeft er nergens een. Al het andere volgt daaruit.
| Wat er blijft | Is het terug te koppelen? | Status onder de AVG | |
|---|---|---|---|
| Ruwe data | Alles: namen, e-mailadressen, telefoonnummers, klantnamen, IBAN's, adressen | Ja, er staan al mensen bij naam in | Persoonsgegevens |
| Gepseudonimiseerd | De tekst, met namen vervangen door codes of tokens | Ja, door wie de sleutel heeft | Nog steeds persoonsgegevens (overweging 26, artikel 4, punt 5) |
| Volledig geanonimiseerd (wat wij leveren) | De tekst, met herleidbare gegevens vervangen door labels per soort, zoals [NAAM] of [KLANT] | Nee. Niemand bewaart een sleutel en onthullende context is verwijderd | Buiten de AVG zodra niemand redelijkerwijs een persoon kan identificeren (overweging 26) |
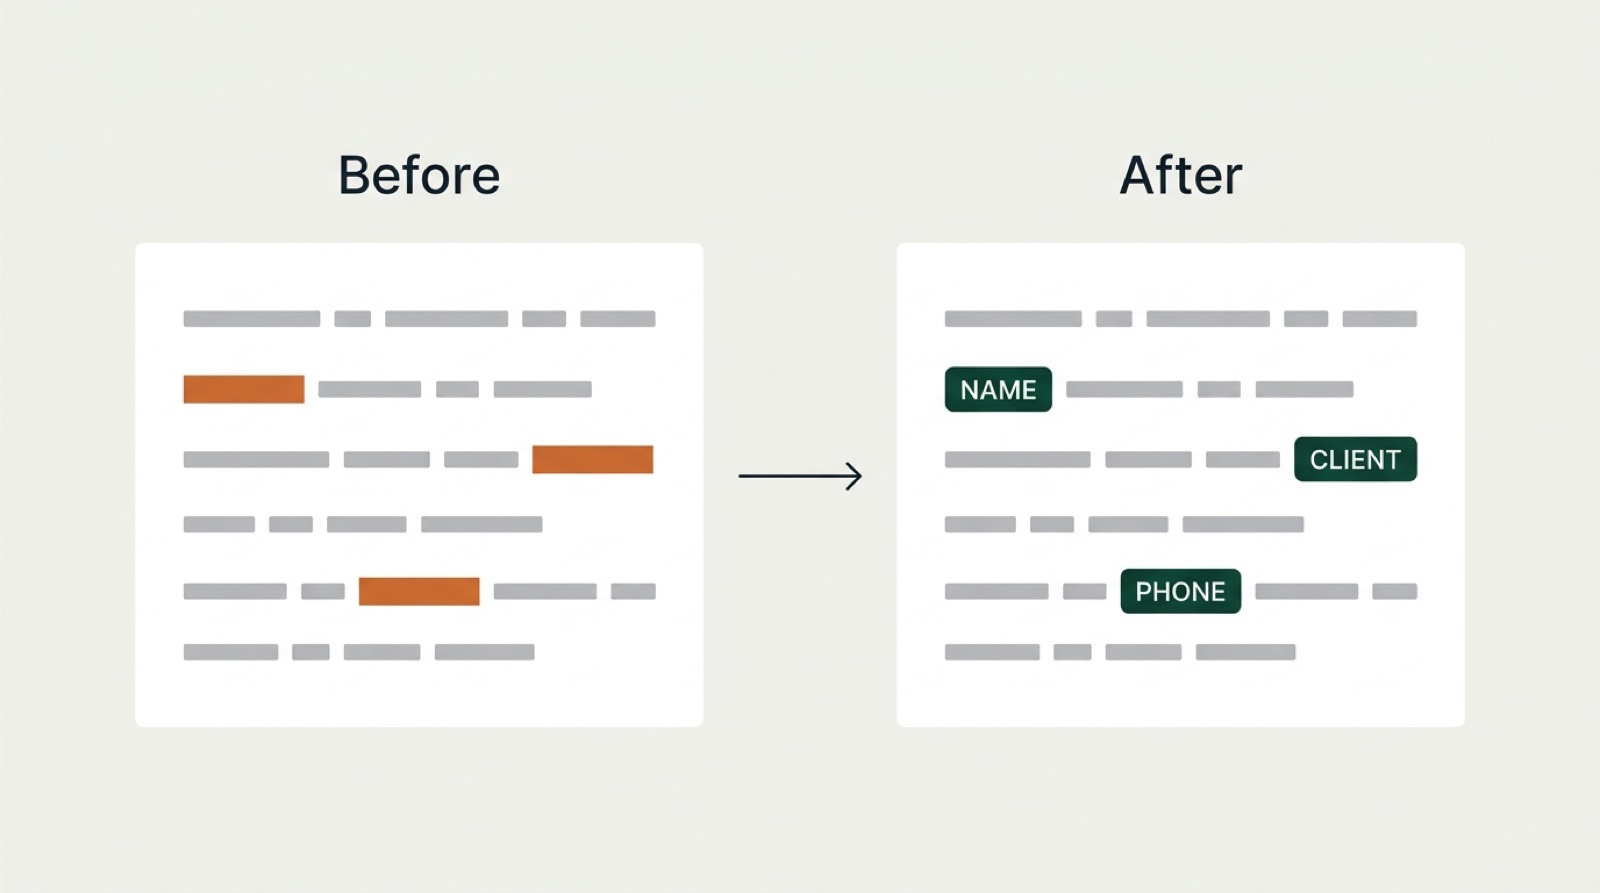
Een praktisch voorbeeld: in een gepseudonimiseerd bestand komt "Medewerker 0042" in 300 berichten voor, dus een lezer kan één persoon door het hele archief volgen. In onze bestanden wordt elke naam hetzelfde label, [NAAM]. Het gesprek blijft te volgen, maar er is geen draadje om aan te trekken.
Gepseudonimiseerde data heeft ergens een sleutel. Volledig geanonimiseerde data heeft nergens een sleutel.
Wat verwijderen we voordat data wordt verkocht?
We verwijderen elk direct herleidbaar gegeven, en daarna de context die naar één persoon kan wijzen. Het eerste deel is mechanisch. Het tweede vraagt om oordeelsvermogen.
- Namen van medewerkers, klanten, leveranciers en contactpersonen, inclusief bijnamen en @vermeldingen
- E-mailadressen, telefoonnummers en postadressen
- Bedrijfsnamen van klanten en leveranciers
- Bank- en IBAN-nummers, en factuur- en contractnummers die naar een rekening leiden
- Klantnummers, gebruikers-ID's, kentekens en andere identificerende nummers
- Handtekeningen, e-mailvoetteksten en profielgegevens
- Context die naar één persoon wijst, zoals "onze enige fiscaal advocaat in Leeuwarden" of de datum van iemands ziekteverlof
Elk item wordt vervangen door een label voor zijn soort, zodat de tekst zijn vorm houdt. De voorbeelden hieronder laten zien hoe dat eruitziet bij alledaagse gegevens.
- Slack, #sales
Anouk, kun jij Pieter Verbeek van Brightwater Foods voor vrijdag bellen? Direct nummer: +31 6 12345678. Ze willen de prijs van vorig jaar.
- Jira-ticket
Factuurexport mislukt voor Kroonstad Logistics. Gemeld door Tom de Wit, contact l.jansen@kroonstad.example. Gereproduceerd op staging.
- E-mail
Hoi Marieke, wil je de borg voor maandag overmaken naar NL00 BANK 0123 4567 89? De sleutels liggen op ons kantoor in Utrecht. Groet, Joost Bakker
- CRM-notitie
Gesproken met Sanne Vos van Hollander Bouw in Zwolle. Wil een offerte voor 40 licenties. Opvolgen via sanne@hollanderbouw.example.
Elk label is algemeen. Er wordt geen sleutel naar het origineel bewaard.
Context is het lastige deel. "Onze CFO" wijst in elk bedrijf één persoon aan. Een functietitel in een team van drie, een plaatsnaam plus een zeldzame gebeurtenis, of een genoemd salaris kan hetzelfde doen. Voegt een detail weinig toe voor een koper, dan laten we het weg. Doet het er wel toe, dan maken we het algemener, bijvoorbeeld "een senior manager" in plaats van een titel die maar één persoon draagt.
Wat blijft helemaal buiten de dataset?
Sommige data maakt nooit deel uit van een verkoop, opgeschoond of niet. Het risico is te groot, of de data is niet van u om te verkopen.
- Gezondheidsgegevens, waaronder ziekmeldingen en medische details in HR-dossiers
- BSN's, paspoortnummers en vergelijkbare identificatienummers van de overheid
- Andere bijzondere categorieën onder de AVG, zoals religie, lidmaatschap van een vakbond, seksuele geaardheid en biometrische gegevens
- Klantdata die u als verwerker bewaart, bijvoorbeeld de salarisadministratie die u voor klanten voert of data die u voor klanten host
- Materiaal onder verschoningsrecht of vertrouwelijk klantmateriaal, tenzij het volledig kan worden opgeschoond
Beroepen met een geheimhoudingsplicht vragen extra zorg. Onze pagina over data verkopen als advocatenkantoor laat zien wat erin mag en wat buiten blijft. Sjablonen, werkprocessen en interne vakkennis zijn meestal nog steeds waardevol zonder één enkel klantgegeven.
Hoe anonimiseert u data uit Slack, Teams of e-mail?
We combineren automatische detectie met controle door mensen. Software vindt de voor de hand liggende patronen op grote schaal: namen, e-mailadressen, telefoonnummers, IBAN's, postcodes. Daarna lezen mensen steekproeven van het resultaat en zoeken naar wat software mist, zoals context die naar één persoon wijst.
Slack en Teams
In chatdata zit identiteit op meer plekken dan in de berichttekst. Weergavenamen, @vermeldingen, gebruikers-ID's, kanaalnamen als #klant-brightwater en namen van gedeelde bestanden krijgen allemaal dezelfde behandeling. Emoji en tijdstempels blijven staan, omdat ze laten zien hoe werk verloopt, maar exacte tijden kunnen worden afgerond waar ze iemand zouden identificeren. Onze pagina over Slack-, Teams- en Jira-data verkopen legt uit wat labs van elke tool leren.
E-mail verstopt herleidbare gegevens in headers, handtekeningen, juridische voetteksten en lange reeksen geciteerde antwoorden. We schonen de regels Van, Aan en Cc op, halen handtekeningen en voetteksten weg en behandelen elk geciteerd antwoord als tekst die opnieuw moet worden opgeschoond. Een naam die bovenaan een wisseling is verwijderd, mag onderaan niet in een geciteerd bericht blijven staan.
Tickets, CRM en documenten
Tickets en CRM-notities staan vol klantnamen, rekeningnummers en contactgegevens. Documenten voegen headers, auteursvelden en bestandsmetadata toe. We schonen de zichtbare tekst en de metadata op, omdat het auteursveld van een bestand net zo goed een persoon kan noemen als de eerste regel.
- We leggen schriftelijk vast welke bronnen meegaan en welke niet.
- Automatische detectie markeert herleidbare gegevens in de volledige set.
- Gemarkeerde items worden vervangen door labels per soort, zoals [NAAM] of [IBAN].
- Controleurs lezen steekproeven en zoeken naar onthullende context.
- Wat ze vinden, wordt in de hele set hersteld, niet alleen in de steekproef.
Kan geanonimiseerde data opnieuw worden herleid?
Slecht geanonimiseerde data wel. Goed geanonimiseerde data hoort dat niet te kunnen. De Artikel 29-werkgroep, waarin de Europese toezichthouders voor gegevensbescherming samenwerkten, beschreef in haar Advies 05/2014 over anonimiseringstechnieken drie manieren waarop het misgaat: één persoon eruit lichten, gegevens over dezelfde persoon aan elkaar koppelen, en feiten over een persoon afleiden uit andere details.
Onze stappen sluiten aan op die drie risico's. Algemene labels voorkomen koppelen, omdat elke naam er hetzelfde uitziet. Onthullende context weghalen voorkomt dat iemand eruit wordt gelicht. Gezondheidsgegevens en andere bijzondere categorieën weglaten beperkt wat iemand zou kunnen afleiden.
De sleutel weegt het zwaarst. Als er een lijst bestond die labels aan echte namen koppelt, kon iedereen die haar in handen kreeg het werk ongedaan maken. Daarom maken we zo'n lijst nooit. Niemand heeft haar: wij niet, u niet en de koper niet. Zodra de originelen zijn verwijderd, is er niets meer om tegen te vergelijken.
Geen methode is perfect, en dat zeggen we liever eerlijk. Daarom controleert een mens het resultaat, controleert u een steekproef en geven we alleen licenties aan AI-labs en onderzoeksteams onder contract. Er wordt niets gepubliceerd.
Wat controleert u voordat er iets wordt verkocht?
U controleert een opgeschoonde steekproef en geeft akkoord. Zonder dat akkoord wordt er niets verkocht. De stappen hieronder zijn het slot van hoe een verkoop verloopt, van overdracht tot betaling.
- Veilige overdracht: versleutelde leestoegang tot de bronnen die u goedkeurt, vanaf dag één onder geheimhouding.
- Wij schonen op: namen, klantgegevens en andere herleidbare gegevens worden tijdens de verwerking verwijderd.
- U keurt goed: u leest een opgeschoonde steekproef. Ziet u iets, dan herstellen we het in de hele set en controleert u opnieuw.
- Originelen verwijderd: zodra de verwerking klaar is, verwijderen we onze kopie van uw originelen. De uwe blijven waar ze waren.
- Betaald: het geld staat binnen 7 dagen op uw rekening nadat de data de controle heeft doorstaan.
Kopers zien alleen geredigeerde steekproeven. Het volledige pakket wordt vrijgegeven nadat ze hebben betaald. We geven nooit licenties aan uw concurrenten.
Anonimiseren maakt de waarde niet ongedaan. Labs willen de redenering, het heen en weer en de besluiten, niet de namen. Bedrijfsdata kan €10K–€600K opbrengen, en grotere of gespecialiseerde datasets kunnen tot honderdduizenden euro's opleveren. Onze pagina over waarom bedrijfsdata geld waard is legt uit wat de prijs bepaalt.
Moeten medewerkers worden geïnformeerd?
Ja. De uiteindelijke dataset is geanonimiseerd, maar het maken ervan niet. Om uw berichten op te schonen, moet iemand ze verwerken terwijl de namen er nog in staan. Die stap is een verwerking van persoonsgegevens onder de AVG, en het hierboven genoemde Advies 05/2014 zegt hetzelfde: anonimiseren is zelf een verdere verwerking.
Geanonimiseerde data valt buiten de AVG. Het anonimiseren zelf niet.
In de praktijk betekent dat drie dingen aan uw kant. U heeft een vastgelegde afweging nodig: een toets of het nieuwe doel verenigbaar is, meestal een belangenafweging voor het gerechtvaardigd belang en vaak een DPIA. U moet transparant zijn: een bijgewerkte privacyverklaring die medewerkers en contactpersonen vertelt dat kopies zonder herleidbare gegevens in licentie kunnen worden gegeven voor AI-training, met een eenvoudige manier om bezwaar te maken. En heeft u een ondernemingsraad, betrek die dan vroeg.
Onze gids over of het legaal is om bedrijfsdata te verkopen onder de AVG loopt elke stap door, met een checklist. De afbakening en voorwaarden die we met u tekenen, geven u bovendien een stuk voor uw eigen administratie.
Vragen
Is geanonimiseerde data onder de AVG nog een persoonsgegeven?
Niet als ze echt anoniem is. Overweging 26 van de AVG zegt dat de regels niet gelden voor gegevens waarbij een persoon niet meer identificeerbaar is met middelen waarvan redelijkerwijs te verwachten is dat ze worden gebruikt. Gepseudonimiseerde data, waarvoor nog een sleutel bestaat, blijft een persoonsgegeven.
Wat is het verschil tussen anonymised en anonymized data?
Geen. Dit zijn de Engelse termen voor geanonimiseerde data: anonymised is de Britse spelling en anonymized de Amerikaanse. Beide betekenen data die niet meer aan een persoon kan worden gekoppeld.
Bewaren jullie een sleutel om data zo nodig te herleiden?
Nee. We vervangen herleidbare gegevens door algemene labels zoals [NAAM] en maken nooit een lijst die labels aan personen koppelt. Met zo'n lijst zou de data gepseudonimiseerd zijn, en dus nog steeds een persoonsgegeven.
Kan ik zien hoe mijn data er na het opschonen uitziet?
Ja. U controleert een opgeschoonde steekproef voordat er iets wordt verkocht, en zonder uw akkoord gaat niets door. Ziet u iets, dan herstellen we het in de hele set.
Wat gebeurt er met mijn originele data?
U houdt haar en blijft haar gebruiken, want u geeft een kopie in licentie. Onze kopie van de originelen wordt verwijderd zodra de verwerking klaar is.
Gaan medische of HR-gegevens ooit mee?
Gezondheidsgegevens, nationale identificatienummers en andere bijzondere categorieën blijven volledig buiten. HR-dossiers met dat soort details worden uitgesloten, niet opgeschoond en verkocht.
Maakt anonimiseren de data waardeloos voor AI-labs?
Nee. Labs trainen op hoe werk wordt gedaan: de vragen, de redenering en de besluiten. Namen en telefoonnummers voegen daar niets aan toe, dus ze weghalen kost heel weinig waarde.
Wie koopt de geanonimiseerde data?
AI-labs en onderzoeksteams die modellen trainen en testen, onder contract. We geven nooit licenties aan uw concurrenten en er wordt niets gepubliceerd.
Dit is algemene informatie, geen juridisch advies.