Che cosa significa vendere dati aziendali anonimizzati?
Significa che un acquirente riceve la sostanza del suo lavoro e nessuna delle persone che vi compaiono. Un laboratorio di IA impara come il suo team gestisce un reclamo, definisce un progetto o corregge un bug. Non scopre mai chi ha scritto il messaggio, quale cliente riguardava o come contattare qualcuno.
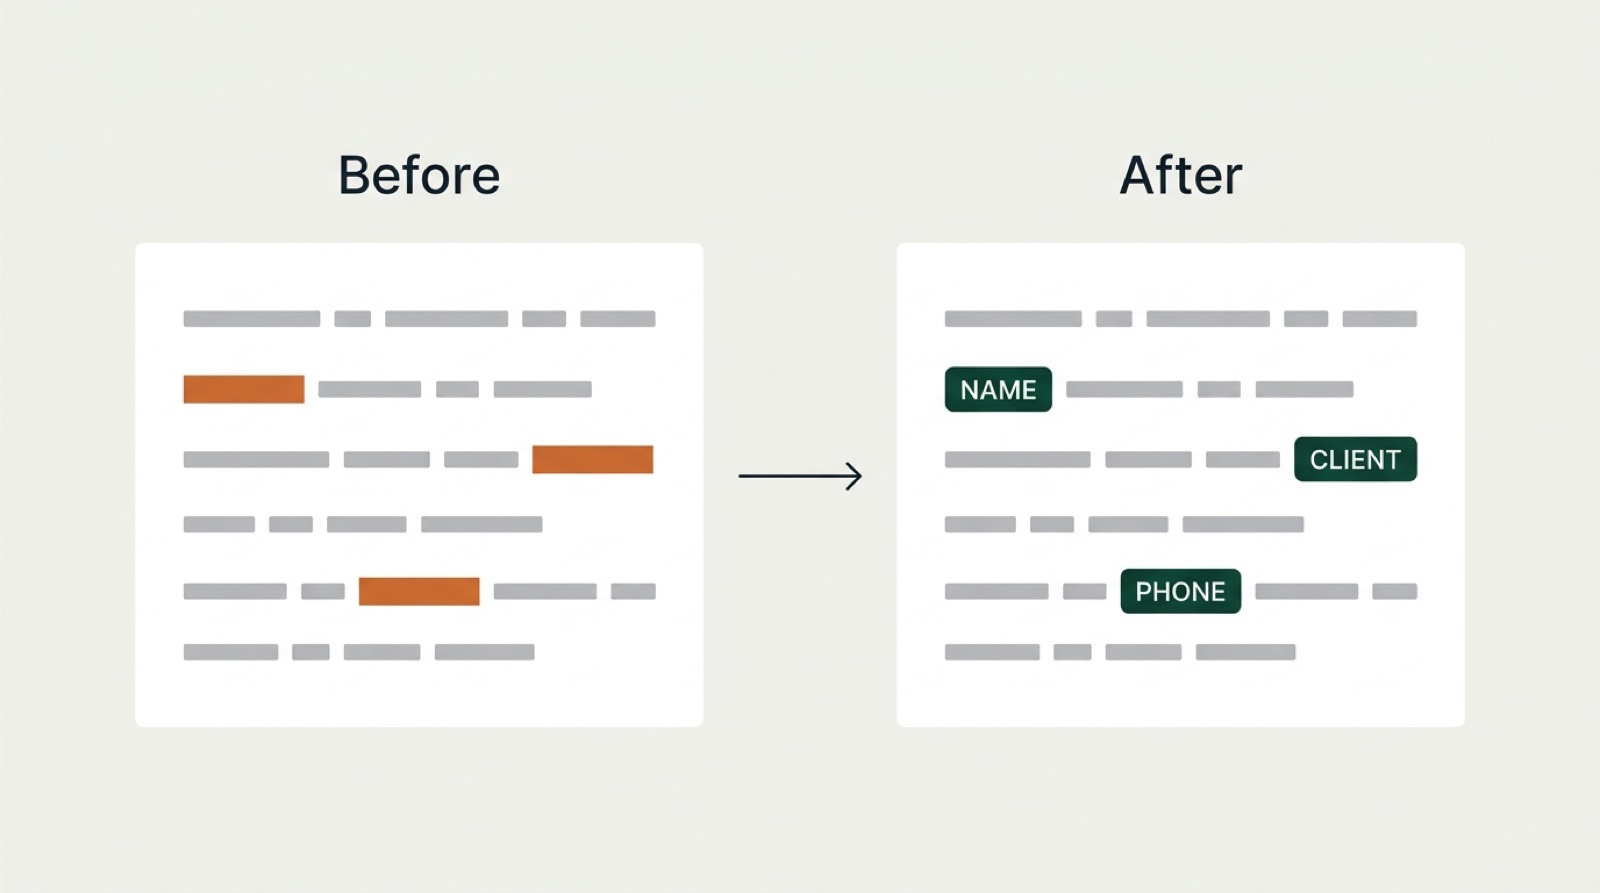
Compriamo questo tipo di dati da aziende a partire da circa 10 persone: messaggi di Slack e Teams, email, documenti, ticket, schede del CRM, codice e procedure. Li ripuliamo e poi li concediamo in licenza ai laboratori di IA che addestrano e testano modelli. Lei conserva gli originali e continua a usarli. Concede in licenza una copia.
La nostra affermazione è semplice: ciò che consegniamo è completamente anonimizzato. Un'affermazione del genere ha senso solo se è sostenuta da passaggi concreti. Questa pagina li elenca, e dice anche con chiarezza dove il GDPR continua a valere per lei.
Cosa sono i dati anonimizzati secondo il GDPR?
I dati anonimizzati sono informazioni che non si riferiscono più a una persona identificata o identificabile. Il GDPR non si applica a questi dati. La regola si trova nel considerando 26 del GDPR, secondo cui i principi di protezione dei dati non dovrebbero applicarsi ai dati resi anonimi in modo da impedire l'identificazione della persona. Nei testi in inglese si trovano le grafie anonymised e anonymized, che indicano la stessa cosa.
Il criterio è rigoroso. Il considerando 26 chiede se qualcuno potrebbe identificare una persona usando tutti i mezzi di cui si può ragionevolmente prevedere l'utilizzo, da parte sua o di altri. Tra i fattori indica i costi, il tempo e la tecnologia disponibile. Togliere un nome non basta se il resto del documento rivela comunque di chi si tratta.
Anonimizzazione
L'anonimizzazione è il processo che trasforma i dati personali in dati anonimizzati, in modo definitivo. Dopo, nessuno, né noi né lei, può ricondurre un documento a una persona. Il risultato è fuori dall'ambito del GDPR.
Pseudonimizzazione
La pseudonimizzazione è definita all'articolo 4, punto 5, del GDPR. Significa trattare i dati in modo che non possano più essere attribuiti a una persona senza informazioni aggiuntive, conservate separatamente e protette. Sostituire "Anna de Vries" con "Dipendente 0042" e conservare l'elenco che collega l'uno all'altro è pseudonimizzazione.
Il considerando 26 è chiaro: i dati pseudonimizzati restano dati personali, perché possono essere ricondotti alla persona grazie a quelle informazioni aggiuntive. Per questo non conserviamo alcun elenco, nessuna tabella di corrispondenza e nessuna mappatura di alcun tipo.
Anonimizzazione o pseudonimizzazione: qual è la differenza?
La differenza è la chiave. I dati pseudonimizzati ne hanno una, da qualche parte. I dati anonimizzati non ne hanno nessuna, da nessuna parte. Tutto il resto discende da qui.
| Cosa si conserva | Si possono ricondurre alla persona? | Status secondo il GDPR | |
|---|---|---|---|
| Dati grezzi | Tutto: nomi, email, numeri di telefono, nomi dei clienti, IBAN, indirizzi | Sì, nominano già le persone | Dati personali |
| Pseudonimizzati | Il testo, con i nomi sostituiti da codici o token | Sì, da chi detiene la chiave | Ancora dati personali (considerando 26, articolo 4, punto 5) |
| Completamente anonimizzati (ciò che consegniamo) | Il testo, con gli identificativi sostituiti da etichette di tipo come [NOME] o [CLIENTE] | No. Nessuno conserva una chiave e il contesto rivelatore viene rimosso | Fuori dal GDPR quando nessuno può ragionevolmente identificare una persona (considerando 26) |
Un esempio pratico: in un file pseudonimizzato "Dipendente 0042" compare in 300 messaggi, quindi chi legge può seguire una persona in tutto l'archivio. Nei nostri file ogni nome diventa la stessa etichetta, [NOME]. La conversazione resta comprensibile, ma non c'è un filo da tirare.
I dati pseudonimizzati hanno una chiave da qualche parte. I dati completamente anonimizzati non hanno una chiave da nessuna parte.
Cosa rimuoviamo prima della vendita?
Rimuoviamo ogni identificativo diretto, e poi il contesto che potrebbe rimandare a una singola persona. La prima parte è meccanica. La seconda richiede giudizio.
- Nomi di dipendenti, clienti, fornitori e referenti, compresi soprannomi e @menzioni
- Indirizzi email, numeri di telefono e indirizzi postali
- Ragioni sociali di clienti e fornitori
- Numeri di conto e IBAN, numeri di fattura e di contratto che portano a un conto
- Codici cliente, ID utente, targhe e altri numeri identificativi
- Firme, piè di pagina delle email e dati del profilo
- Contesto che rimanda a una sola persona, come "il nostro unico avvocato tributarista a Leeds" o la data della malattia di qualcuno
Ogni elemento viene sostituito da un'etichetta che ne indica il tipo, così il testo mantiene la sua forma. Gli esempi qui sotto mostrano come appare su documenti di tutti i giorni.
- Slack, #vendite
Anouk, puoi chiamare Pieter Verbeek di Brightwater Foods entro venerdì? Numero diretto: +31 6 12345678. Vogliono il prezzo dell'anno scorso.
- Ticket Jira
L'esportazione delle fatture non funziona per Kroonstad Logistics. Segnalato da Tom de Wit, referente l.jansen@kroonstad.example. Riprodotto in staging.
- Email
Ciao Marieke, ti chiedo di versare la caparra su NL00 BANK 0123 4567 89 entro lunedì. Le chiavi sono nel nostro ufficio di Utrecht. Cordiali saluti, Joost Bakker
- Nota CRM
Incontrata Sanne Vos di Hollander Bouw a Zwolle. Vuole un preventivo per 40 postazioni. Ricontattare a sanne@hollanderbouw.example.
Ogni etichetta è generica. Non si conserva alcuna chiave per risalire all'originale.
Il contesto è la parte difficile. "Il nostro CFO" indica una sola persona in qualsiasi azienda. Una qualifica in un team di tre persone, una città abbinata a un evento raro o uno stipendio citato possono fare lo stesso. Quando un dettaglio aggiunge poco per un acquirente, lo eliminiamo. Quando conta, lo rendiamo più generico, per esempio "un dirigente" al posto di una qualifica che ha una sola persona.
Cosa resta del tutto fuori dal set di dati?
Alcuni dati non entrano mai in una vendita, ripuliti o no. Il rischio è troppo alto, oppure i dati non sono suoi da vendere.
- Dati sanitari, compresi certificati di malattia e informazioni mediche nei fascicoli del personale
- Numeri di identificazione nazionali, numeri di passaporto e identificativi pubblici simili
- Altre categorie particolari previste dal GDPR, come religione, appartenenza sindacale, orientamento sessuale e dati biometrici
- Dati dei clienti che conserva come responsabile del trattamento, per esempio le paghe che elabora per i clienti o i dati che ospita per loro
- Materiale coperto da segreto professionale o riservato dei clienti, a meno che non possa essere ripulito del tutto
Le professioni tenute al segreto richiedono più attenzione. La nostra pagina sulla vendita dei dati di uno studio legale mostra cosa resta dentro e cosa resta fuori. Modelli, flussi di lavoro e know-how interno di solito mantengono il loro valore anche senza un solo dato dei clienti.
Come si anonimizzano i dati di Slack, Teams o delle email?
Combiniamo il rilevamento automatico con la revisione umana. Il software individua su larga scala gli schemi evidenti: nomi, indirizzi email, numeri di telefono, IBAN, codici postali. Poi alcune persone leggono campioni del risultato e cercano ciò che il software non vede, come un contesto che rimanda a una sola persona.
Slack e Teams
Nei dati di chat l'identità si nasconde in più punti del solo testo del messaggio. Nomi visualizzati, @menzioni, ID utente, nomi di canale come #client-brightwater e nomi dei file condivisi ricevono lo stesso trattamento. Emoji e orari restano, perché mostrano come scorre il lavoro, ma gli orari esatti possono essere resi meno precisi dove identificherebbero qualcuno. La nostra pagina sulla vendita di dati di Slack, Teams e Jira spiega cosa imparano i laboratori da ciascuno strumento.
Le email nascondono identificativi nelle intestazioni, nelle firme, nelle note legali a piè di pagina e nelle lunghe catene di risposte citate. Ripuliamo le righe Da, A e Cc, eliminiamo firme e piè di pagina e trattiamo ogni risposta citata come testo da ripulire di nuovo. Un nome rimosso in cima a un thread non deve sopravvivere in un messaggio citato in fondo.
Ticket, CRM e documenti
Ticket e note del CRM sono pieni di nomi di clienti, numeri di conto e recapiti. I documenti aggiungono intestazioni, campi autore e metadati dei file. Ripuliamo sia il testo visibile sia i metadati, perché il campo autore di un file può nominare una persona tanto quanto la sua prima riga.
- Concordiamo per iscritto quali fonti sono incluse e quali no.
- Il rilevamento automatico etichetta gli identificativi nell'intero set.
- Gli elementi etichettati vengono sostituiti da etichette di tipo come [NOME] o [IBAN].
- I revisori leggono campioni e cercano contesti rivelatori.
- Tutto ciò che trovano viene corretto nell'intero set, non solo nel campione.
I dati anonimizzati possono essere reidentificati?
I dati anonimizzati male sì. Quelli anonimizzati bene non dovrebbero. Il Gruppo di lavoro Articolo 29, in cui collaboravano le autorità di protezione dei dati dell'UE, ha descritto tre modi in cui le cose vanno storte nel suo Parere 05/2014 sulle tecniche di anonimizzazione: individuare una singola persona, collegare documenti relativi alla stessa persona e dedurre informazioni su una persona da altri dettagli.
I nostri passaggi rispondono a questi tre rischi. Le etichette generiche impediscono il collegamento, perché ogni nome appare uguale. Rimuovere il contesto rivelatore impedisce l'individuazione. Escludere i dati sanitari e le altre categorie particolari limita ciò che chiunque potrebbe dedurre.
La chiave è ciò che conta di più. Se esistesse un elenco che collega le etichette ai nomi reali, chiunque ne entrasse in possesso potrebbe annullare il lavoro. Per questo non lo creiamo mai. Nessuno lo possiede: né noi, né lei, né l'acquirente. Una volta cancellati gli originali, non resta nulla con cui fare un confronto.
Nessun metodo è perfetto, e preferiamo dirlo. Per questo una persona rivede il risultato, lei controlla un campione e concediamo licenze solo a laboratori di IA e team di ricerca con un contratto. Nulla viene pubblicato.
Cosa verifica lei prima di qualsiasi vendita?
Controlla un campione ripulito e dà il via libera. Senza questa approvazione non si vende nulla. I passaggi qui sotto sono la parte finale di come funziona una vendita, dalla consegna al pagamento.
- Consegna sicura: accesso cifrato e in sola lettura alle fonti che approva, sotto NDA dal primo giorno.
- Ripuliamo i dati: nomi, dati dei clienti e altri elementi identificativi vengono rimossi durante il trattamento.
- Lei approva: legge un campione ripulito. Se nota qualcosa, lo correggiamo nell'intero set e lei controlla di nuovo.
- Originali cancellati: al termine del trattamento cancelliamo la nostra copia dei suoi originali. I suoi restano dove erano.
- Pagamento: il denaro arriva sul suo conto entro 7 giorni da quando i dati superano la verifica.
Gli acquirenti vedono solo campioni oscurati. Il pacchetto completo viene consegnato dopo il pagamento. Non concediamo mai licenze ai suoi concorrenti.
L'anonimizzazione non cancella il valore. I laboratori vogliono il ragionamento, il botta e risposta e le decisioni, non i nomi. I dati di un'azienda possono valere €10K–€600K, e set di dati più grandi o specialistici possono arrivare fino a centinaia di migliaia di euro. La nostra pagina sul perché i dati aziendali valgono denaro spiega cosa determina il prezzo.
I dipendenti devono essere informati?
Sì. Il set di dati finale è anonimizzato, ma il lavoro per ottenerlo no. Per ripulire i suoi messaggi qualcuno deve trattarli mentre contengono ancora dei nomi. Quel passaggio è un trattamento di dati personali secondo il GDPR, e il Parere 05/2014 citato sopra dice la stessa cosa: l'anonimizzazione è essa stessa un trattamento ulteriore.
I dati anonimizzati sono fuori dal GDPR. Il processo per anonimizzarli no.
In pratica questo comporta tre cose da parte sua. Serve una valutazione documentata: una verifica di compatibilità per la nuova finalità, di solito una valutazione del legittimo interesse e spesso una DPIA. Serve trasparenza: un'informativa privacy aggiornata che comunichi a personale e contatti che copie de-identificate possono essere concesse in licenza per l'addestramento dell'IA, con un modo semplice per opporsi. E se c'è un consiglio aziendale, va coinvolto per tempo.
La nostra guida su se è legale vendere dati aziendali secondo il GDPR spiega ogni passaggio con una checklist. Il perimetro e le condizioni che firmiamo con lei le danno anche una documentazione da conservare nei suoi archivi.
Domande
I dati anonimizzati sono ancora dati personali secondo il GDPR?
No, se sono davvero anonimi. Il considerando 26 del GDPR stabilisce che le regole non si applicano ai dati in cui una persona non è più identificabile con alcun mezzo di cui si possa ragionevolmente prevedere l'utilizzo. I dati pseudonimizzati, per i quali esiste ancora una chiave, restano dati personali.
Che differenza c'è tra anonymised e anonymized?
Nessuna. Sono i due modi in cui si scrive in inglese "anonimizzato": anonymised è la grafia britannica, anonymized quella americana. Entrambi indicano dati che non possono più essere ricondotti a una persona.
Conservate una chiave per risalire ai dati in caso di necessità?
No. Sostituiamo gli identificativi con etichette generiche come [NOME] e non creiamo mai un elenco che colleghi le etichette alle persone. Conservare un elenco del genere renderebbe i dati pseudonimizzati, e quindi ancora dati personali.
Posso vedere come appaiono i miei dati dopo la pulizia?
Sì. Controlla un campione ripulito prima di qualsiasi vendita, e nulla va avanti senza il suo via libera. Se nota qualcosa, lo correggiamo nell'intero set.
Che fine fanno i miei dati originali?
Li conserva e continua a usarli, perché concede in licenza una copia. La nostra copia degli originali viene cancellata al termine del trattamento.
I dati medici o del personale vengono mai inclusi?
Dati sanitari, numeri di identificazione nazionali e altre categorie particolari restano del tutto fuori. I fascicoli del personale con questo tipo di dettagli vengono esclusi, non ripuliti e venduti.
L'anonimizzazione rende i dati inutili per i laboratori di IA?
No. I laboratori addestrano i modelli su come si lavora: le domande, il ragionamento e le decisioni. Nomi e numeri di telefono non aggiungono nulla a questo, quindi rimuoverli costa pochissimo in termini di valore.
Chi compra i dati anonimizzati?
Laboratori di IA e team di ricerca che addestrano e testano modelli, con un contratto. Non concediamo mai licenze ai suoi concorrenti e nulla viene pubblicato.
Queste sono informazioni generali, non una consulenza legale.