Que signifie vendre des données d'entreprise anonymisées ?
Cela signifie qu'un acheteur reçoit la substance de votre travail, sans aucune des personnes qui y figurent. Un labo d'IA apprend comment votre équipe traite une réclamation, cadre un projet ou corrige un bug. Il n'apprend jamais qui a écrit le message, de quel client il s'agissait ni comment joindre qui que ce soit.
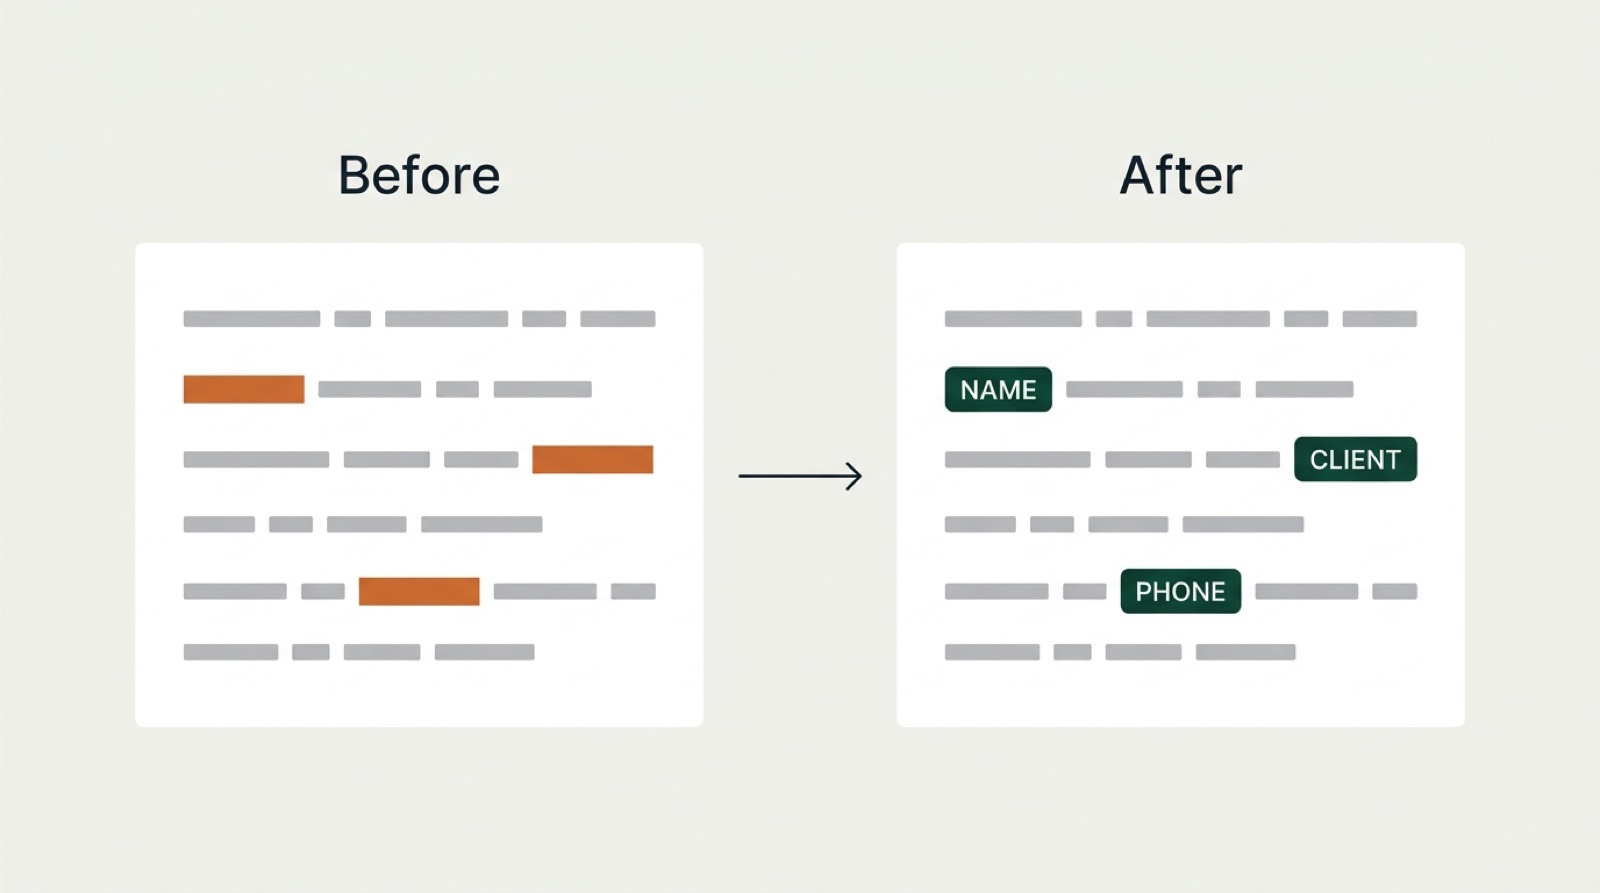
Nous achetons ce type de données auprès d'entreprises d'environ 10 personnes et plus : messages Slack et Teams, e-mails, documents, tickets, fiches CRM, code et procédures. Nous les nettoyons, puis les cédons sous licence à des labos d'IA qui entraînent et testent des modèles. Vous gardez vos originaux et continuez à les utiliser. Vous cédez une copie sous licence.
Notre engagement est simple : ce que nous livrons est entièrement anonymisé. Cet engagement n'a de sens que s'il repose sur des étapes concrètes. Cette page les détaille, et elle dit aussi clairement où le RGPD continue de s'appliquer à vous.
Qu'est-ce qu'une donnée anonymisée au sens du RGPD ?
Une donnée anonymisée est une information qui ne se rapporte plus à une personne identifiée ou identifiable. Le RGPD ne s'y applique pas. Cette règle figure au considérant 26 du RGPD, selon lequel les principes de protection des données ne devraient pas s'appliquer aux données rendues anonymes de telle manière que la personne n'est plus identifiable. On parle aussi de données anonymes ou rendues anonymes : l'idée est la même.
Le critère est strict. Le considérant 26 demande si quelqu'un pourrait identifier une personne en utilisant tous les moyens raisonnablement susceptibles d'être utilisés, par vous ou par un tiers. Il cite le coût, le temps nécessaire et les technologies disponibles parmi les facteurs à prendre en compte. Retirer un nom ne suffit pas si le reste de la donnée trahit encore la personne.
Anonymisation
L'anonymisation est le processus qui transforme des données personnelles en données anonymisées, de façon définitive. Personne, ni nous ni vous, ne peut ensuite remonter d'une donnée à une personne. Le résultat sort du champ du RGPD.
Pseudonymisation
La pseudonymisation est définie à l'article 4(5) du RGPD. Elle consiste à traiter des données de sorte qu'elles ne puissent plus être attribuées à une personne sans recourir à des informations supplémentaires, conservées séparément et protégées. Remplacer « Anna de Vries » par « Salariée 0042 » en gardant la liste qui fait correspondre l'un à l'autre, c'est de la pseudonymisation.
Le considérant 26 indique clairement que des données pseudonymisées restent des données personnelles, puisqu'elles peuvent être rattachées à une personne grâce à ces informations supplémentaires. C'est pourquoi nous ne gardons aucune liste, aucune table de correspondance, aucun mappage d'aucune sorte.
Anonymisation ou pseudonymisation : quelle différence ?
La différence, c'est la clé. Les données pseudonymisées en ont une, quelque part. Les données anonymisées n'en ont aucune, nulle part. Tout le reste en découle.
| Ce qui est conservé | Peut-on remonter à la personne ? | Statut au regard du RGPD | |
|---|---|---|---|
| Données brutes | Tout : noms, e-mails, numéros de téléphone, noms de clients, IBAN, adresses | Oui, elles nomment déjà des personnes | Données personnelles |
| Pseudonymisées | Le texte, avec les noms remplacés par des codes ou des jetons | Oui, pour quiconque détient la clé | Toujours des données personnelles (considérant 26, article 4(5)) |
| Entièrement anonymisées (ce que nous livrons) | Le texte, avec les identifiants remplacés par des balises de type, comme [NAME] ou [CLIENT] | Non. Personne ne conserve de clé, et le contexte révélateur est retiré | Hors du champ du RGPD dès lors que personne ne peut raisonnablement identifier une personne (considérant 26) |
Un exemple concret : dans un fichier pseudonymisé, « Salariée 0042 » apparaît dans 300 messages, si bien qu'un lecteur peut suivre une même personne dans toutes les archives. Dans nos fichiers, chaque nom devient la même balise, [NAME]. La conversation garde son sens, mais il n'y a plus de fil à tirer.
Les données pseudonymisées ont une clé quelque part. Les données entièrement anonymisées n'en ont nulle part.
Que retirons-nous avant la vente des données ?
Nous retirons chaque identifiant direct, puis le contexte qui pourrait désigner une personne. La première partie est mécanique. La seconde demande du discernement.
- Les noms des salariés, clients, fournisseurs et contacts, y compris les surnoms et les @mentions
- Les adresses e-mail, numéros de téléphone et adresses postales
- Les noms des entreprises clientes et fournisseurs
- Les numéros de compte bancaire et d'IBAN, les numéros de facture et de contrat qui mènent à un compte
- Les numéros de client, identifiants d'utilisateur, plaques d'immatriculation et autres numéros identifiants
- Les signatures, pieds de page d'e-mail et informations de profil
- Le contexte qui désigne une personne, comme « notre seul fiscaliste à Leeds » ou la date d'un arrêt maladie
Chaque élément est remplacé par une balise indiquant son type, si bien que le texte garde sa forme. Les exemples ci-dessous montrent ce que cela donne sur des données du quotidien.
- Slack, #ventes
Anouk, tu peux appeler Pieter Verbeek chez Brightwater Foods avant vendredi ? Ligne directe : +31 6 12345678. Ils veulent le prix de l'an dernier.
- Ticket Jira
L'export des factures échoue pour Kroonstad Logistics. Signalé par Tom de Wit, contact l.jansen@kroonstad.example. Reproduit en préproduction.
- E-mail
Bonjour Marieke, merci de verser l'acompte sur NL00 BANK 0123 4567 89 d'ici lundi. Les clés sont à notre bureau d'Utrecht. Cordialement, Joost Bakker
- Note CRM
Rencontré Sanne Vos de Hollander Bouw à Zwolle. Veut un devis pour 40 postes. Relancer à sanne@hollanderbouw.example.
Chaque balise est générique. Aucune clé vers l'original n'est conservée.
Le contexte est la partie difficile. « Notre directeur financier » désigne une seule personne dans n'importe quelle entreprise. Un intitulé de poste dans une équipe de trois, une ville associée à un événement rare ou un salaire cité peuvent faire de même. Quand un détail apporte peu à un acheteur, nous le supprimons. Quand il compte, nous le rendons plus général, par exemple « un cadre dirigeant » au lieu d'un intitulé que porte une seule personne.
Qu'est-ce qui reste totalement en dehors du jeu de données ?
Certaines données ne font jamais partie d'une vente, nettoyées ou non. Le risque est trop élevé, ou les données ne sont pas à vous.
- Les données de santé, y compris les arrêts maladie et les informations médicales des dossiers RH
- Les numéros d'identification nationaux, numéros de passeport et identifiants officiels similaires
- Les autres catégories particulières de données au sens du RGPD, comme la religion, l'appartenance syndicale, l'orientation sexuelle et les données biométriques
- Les données clients que vous traitez en tant que sous-traitant, par exemple la paie que vous gérez pour des clients ou les données que vous hébergez pour eux
- Les contenus couverts par le secret professionnel ou confidentiels pour les clients, sauf s'ils peuvent être entièrement épurés
Les professions soumises au secret doivent redoubler de prudence. Notre page sur la vente de données d'un cabinet d'avocats montre ce qui est inclus et ce qui est exclu. Les modèles, processus et savoir-faire internes gardent en général leur valeur sans le moindre détail client.
Comment anonymiser des données Slack, Teams ou des e-mails ?
Nous combinons la détection automatique et la relecture humaine. Un logiciel repère les motifs évidents à grande échelle : noms, adresses e-mail, numéros de téléphone, IBAN, codes postaux. Des personnes lisent ensuite des échantillons du résultat et cherchent ce que le logiciel laisse passer, comme un contexte qui désigne une personne.
Slack et Teams
Dans une messagerie, l'identité se cache ailleurs que dans le texte des messages. Les noms affichés, les @mentions, les identifiants d'utilisateur, les noms de canaux comme #client-brightwater et les noms de fichiers partagés reçoivent tous le même traitement. Les émojis et les horodatages restent, parce qu'ils montrent comment le travail circule, mais les heures exactes peuvent être arrondies quand elles permettraient d'identifier quelqu'un. Notre article sur la vente de données Slack, Teams et Jira explique ce que les labos apprennent de chaque outil.
Les e-mails cachent des identifiants dans les en-têtes, les signatures, les mentions légales et les longues chaînes de réponses citées. Nous nettoyons les lignes De, À et Cc, retirons signatures et pieds de page, et traitons chaque réponse citée comme un texte à nettoyer à nouveau. Un nom retiré en haut d'un fil ne doit pas survivre dans un message cité plus bas.
Tickets, CRM et documents
Les tickets et les notes CRM regorgent de noms de clients, de numéros de compte et de coordonnées. Les documents y ajoutent des en-têtes, des champs auteur et des métadonnées de fichier. Nous nettoyons le texte visible et les métadonnées, car le champ auteur d'un fichier peut nommer une personne aussi bien que sa première ligne.
- Nous convenons par écrit des sources incluses et de celles qui sont exclues.
- La détection automatique balise les identifiants dans l'ensemble des données.
- Les éléments balisés sont remplacés par des balises de type, comme [NAME] ou [IBAN].
- Des relecteurs lisent des échantillons et cherchent le contexte révélateur.
- Tout ce qu'ils trouvent est corrigé dans l'ensemble des données, pas seulement dans l'échantillon.
Des données anonymisées peuvent-elles être réidentifiées ?
Des données mal anonymisées, oui. Des données bien anonymisées ne devraient pas l'être. Le groupe de travail « Article 29 », qui réunissait les autorités de protection des données de l'UE, a décrit trois façons dont l'anonymisation échoue dans son avis 05/2014 sur les techniques d'anonymisation : l'individualisation d'une personne, la corrélation de données concernant une même personne, et l'inférence de faits sur une personne à partir d'autres éléments.
Nos étapes répondent à ces trois risques. Les balises génériques empêchent la corrélation, puisque tous les noms se ressemblent. Le retrait du contexte révélateur empêche l'individualisation. L'exclusion des données de santé et des autres catégories particulières limite ce que l'on pourrait déduire.
La clé compte plus que tout. Si une liste reliant les balises aux vrais noms existait, quiconque mettrait la main dessus pourrait défaire le travail. Nous n'en créons donc jamais. Personne ne la détient : ni nous, ni vous, ni l'acheteur. Une fois les originaux supprimés, il ne reste rien à quoi les comparer.
Aucune méthode n'est parfaite, et nous préférons le dire. C'est pourquoi une personne relit le résultat, pourquoi vous vérifiez un échantillon, et pourquoi nous cédons des licences uniquement à des labos d'IA et à des équipes de recherche sous contrat. Rien n'est publié.
Que vérifiez-vous avant toute vente ?
Vous vérifiez un échantillon nettoyé et donnez votre accord. Rien n'est vendu sans cette validation. Les étapes ci-dessous sont la fin du déroulement d'une vente, du transfert au paiement.
- Transfert sécurisé : accès chiffré, en lecture seule, aux sources que vous validez, sous accord de confidentialité dès le premier jour.
- Nous nettoyons : les noms, les informations clients et les autres identifiants sont retirés pendant le traitement.
- Vous validez : vous lisez un échantillon nettoyé. Si vous repérez quelque chose, nous le corrigeons dans l'ensemble des données et vous vérifiez à nouveau.
- Originaux supprimés : une fois le traitement terminé, nous supprimons notre copie de vos originaux. Les vôtres restent où ils étaient.
- Paiement : l'argent arrive sur votre compte dans les 7 jours après la revue des données.
Les acheteurs ne voient que des échantillons caviardés. Le jeu complet n'est remis qu'après paiement. Nous ne cédons jamais de licence à vos concurrents.
L'anonymisation ne détruit pas la valeur. Les labos veulent le raisonnement, les échanges et les décisions, pas les noms. Les données d'une entreprise peuvent rapporter €10K–€600K, et des jeux de données plus volumineux ou spécialisés peuvent atteindre plusieurs centaines de milliers d'euros. Notre page sur la valeur des données d'entreprise explique ce qui fait le prix.
Faut-il informer les salariés ?
Oui. Le jeu de données final est anonymisé, mais sa fabrication ne l'est pas. Pour nettoyer vos messages, quelqu'un doit les traiter alors qu'ils contiennent encore des noms. Cette étape est un traitement de données personnelles au sens du RGPD, et l'avis 05/2014 cité plus haut dit la même chose : l'anonymisation est elle-même un traitement ultérieur.
Les données anonymisées sortent du champ du RGPD. Leur fabrication, non.
En pratique, cela implique trois choses de votre côté. Il vous faut une analyse documentée : un test de compatibilité pour la nouvelle finalité, en général une mise en balance de l'intérêt légitime et souvent une AIPD. Il vous faut de la transparence : une politique de confidentialité mise à jour, qui informe salariés et contacts que des copies désidentifiées peuvent être cédées sous licence pour l'entraînement d'IA, avec un moyen simple de s'y opposer. Et si vous avez des représentants du personnel (CSE ou conseil d'entreprise), associez-les tôt.
Notre guide pour savoir s'il est légal de vendre des données d'entreprise au regard du RGPD détaille chaque étape, avec une checklist. Le périmètre et les conditions que nous signons avec vous vous servent aussi de trace pour vos propres dossiers.
Questions
Des données anonymisées sont-elles encore des données personnelles au sens du RGPD ?
Pas si elles sont réellement anonymes. Le considérant 26 du RGPD indique que les règles ne s'appliquent pas aux données pour lesquelles une personne n'est plus identifiable par aucun moyen raisonnablement susceptible d'être utilisé. Les données pseudonymisées, pour lesquelles une clé existe encore, restent des données personnelles.
Quelle différence entre données anonymisées et données anonymes ?
Dans l'usage courant, aucune. Les deux expressions désignent des données qui ne peuvent plus être rattachées à une personne. « Anonymisées » insiste sur le processus qui les a rendues anonymes.
Gardez-vous une clé pour pouvoir remonter aux données si nécessaire ?
Non. Nous remplaçons les identifiants par des balises génériques comme [NAME] et ne créons jamais de liste qui relie les balises aux personnes. Conserver une telle liste rendrait les données pseudonymisées, donc toujours personnelles.
Puis-je voir à quoi ressemblent mes données après nettoyage ?
Oui. Vous vérifiez un échantillon nettoyé avant toute vente, et rien ne se fait sans votre accord. Si vous repérez quelque chose, nous le corrigeons dans l'ensemble des données.
Que deviennent mes données d'origine ?
Vous les gardez et continuez à les utiliser, puisque vous cédez une copie sous licence. Notre copie des originaux est supprimée une fois le traitement terminé.
Des données médicales ou RH sont-elles parfois incluses ?
Les données de santé, les numéros d'identification nationaux et les autres catégories particulières restent entièrement exclus. Les dossiers RH contenant ce type d'informations sont exclus, et non nettoyés puis vendus.
L'anonymisation fait-elle perdre toute valeur aux données pour les labos d'IA ?
Non. Les labos s'entraînent sur la façon dont le travail se fait : les questions, le raisonnement et les décisions. Les noms et les numéros de téléphone n'y ajoutent rien, si bien que les retirer coûte très peu de valeur.
Qui achète les données anonymisées ?
Des labos d'IA et des équipes de recherche qui entraînent et testent des modèles, sous contrat. Nous ne cédons jamais de licence à vos concurrents, et rien n'est publié.
Ces informations sont d'ordre général et ne constituent pas un conseil juridique.