¿Qué significa vender datos de empresa anonimizados?
Significa que el comprador recibe la sustancia de su trabajo y ninguna de las personas que aparecen en él. Un laboratorio de IA aprende cómo su equipo gestiona una reclamación, define el alcance de un proyecto o corrige un error. Nunca sabe quién escribió el mensaje, de qué cliente se trataba ni cómo contactar con nadie.
Compramos ese tipo de datos a empresas a partir de unas 10 personas: mensajes de Slack y Teams, correo electrónico, documentos, tickets, registros del CRM, código y procedimientos. Los depuramos y después los cedemos bajo licencia a laboratorios de IA que entrenan y evalúan modelos. Usted conserva sus originales y los sigue usando. Cede una copia bajo licencia.
Nuestra afirmación es sencilla: lo que entregamos está totalmente anonimizado. Esa afirmación solo tiene sentido si la respaldan pasos concretos. Esta página los enumera y también dice con claridad en qué puntos el RGPD le sigue afectando.
¿Qué son los datos anonimizados según el RGPD?
Los datos anonimizados son información que ya no guarda relación con una persona identificada o identificable. El RGPD no se les aplica. Esa regla está en el considerando 26 del RGPD, que dice que los principios de protección de datos no deben aplicarse a los datos convertidos en anónimos de forma que la persona deje de ser identificable. A menudo también se habla simplemente de datos anónimos.
La prueba es estricta. El considerando 26 pregunta si alguien podría identificar a una persona con todos los medios que razonablemente puedan utilizarse, ya sea usted u otra persona. Menciona como factores el coste, el tiempo y la tecnología disponible. Quitar un nombre no basta si el resto del registro sigue delatando a la persona.
Anonimización
La anonimización es el proceso de convertir datos personales en datos anonimizados de forma definitiva. Después, nadie, ni nosotros ni usted, puede rastrear un registro hasta una persona. El resultado queda fuera del RGPD.
Seudonimización
La seudonimización se define en el artículo 4, apartado 5, del RGPD. Consiste en tratar los datos de forma que ya no puedan atribuirse a una persona sin información adicional, que se guarda por separado y protegida. Cambiar "Anna de Vries" por "Empleada 0042" y conservar la lista que relaciona una cosa con la otra es seudonimización.
El considerando 26 deja claro que los datos seudonimizados siguen siendo datos personales, porque pueden volver a vincularse con esa información adicional. Por eso no guardamos ninguna lista, ninguna tabla de correspondencias ni ningún tipo de vinculación.
Anonimización frente a seudonimización: ¿cuál es la diferencia?
La diferencia es la clave. Los datos seudonimizados tienen una, en alguna parte. Los datos anonimizados no tienen ninguna, en ninguna parte. Todo lo demás se deriva de eso.
| Qué se conserva | ¿Se puede volver a vincular? | Situación en el RGPD | |
|---|---|---|---|
| Datos en bruto | Todo: nombres, correos, números de teléfono, nombres de clientes, IBAN, direcciones | Sí, ya nombran a personas | Datos personales |
| Seudonimizados | El texto, con los nombres cambiados por códigos o tokens | Sí, quien tenga la clave | Siguen siendo datos personales (considerando 26, artículo 4, apartado 5) |
| Totalmente anonimizados (lo que entregamos) | El texto, con los identificadores sustituidos por etiquetas de tipo como [NOMBRE] o [CLIENTE] | No. Nadie guarda una clave y se elimina el contexto revelador | Fuera del RGPD cuando nadie puede identificar razonablemente a una persona (considerando 26) |
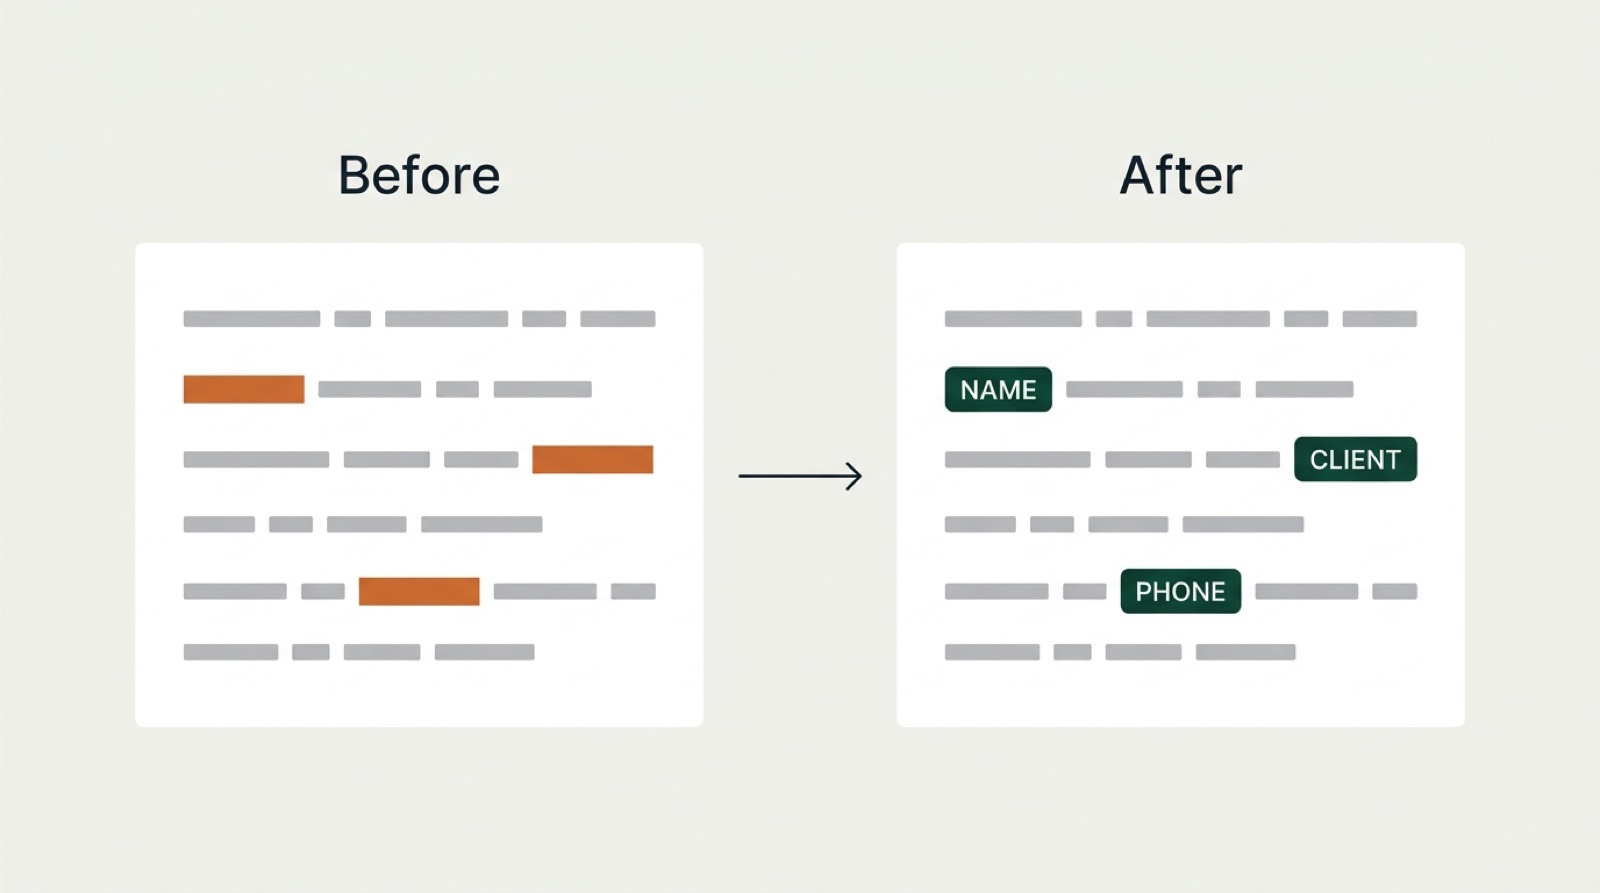
Un ejemplo práctico: en un archivo seudonimizado, "Empleada 0042" aparece en 300 mensajes, así que un lector puede seguir a una persona por todo el archivo. En nuestros archivos, cada nombre se convierte en la misma etiqueta, [NOMBRE]. La conversación sigue teniendo sentido, pero no hay ningún hilo del que tirar.
Los datos seudonimizados tienen una clave en alguna parte. Los datos totalmente anonimizados no tienen clave en ninguna parte.
¿Qué eliminamos antes de vender los datos?
Eliminamos todos los identificadores directos y, después, el contexto que podría apuntar a una persona concreta. La primera parte es mecánica. La segunda requiere criterio.
- Nombres de empleados, clientes, proveedores y contactos, incluidos apodos y @menciones
- Direcciones de correo, números de teléfono y direcciones postales
- Nombres de empresas clientes y proveedoras
- Números de cuenta bancaria e IBAN, y números de factura y de contrato que llevan a una cuenta
- Números de cliente, identificadores de usuario, matrículas y otros números identificativos
- Firmas, pies de correo y datos de perfil
- Contexto que apunta a una sola persona, como "nuestro único abogado fiscalista en Leeds" o la fecha de la baja por enfermedad de alguien
Cada elemento se sustituye por una etiqueta de su tipo, de modo que el texto conserva su forma. Los ejemplos de abajo muestran cómo queda en registros cotidianos.
- Slack, #ventas
Anouk, ¿puedes llamar a Pieter Verbeek de Brightwater Foods antes del viernes? Línea directa: +31 6 12345678. Quieren el precio del año pasado.
- Ticket de Jira
Falla la exportación de facturas para Kroonstad Logistics. Lo notificó Tom de Wit, contacto l.jansen@kroonstad.example. Reproducido en staging.
- Correo
Hola, Marieke: por favor, ingrese la fianza en NL00 BANK 0123 4567 89 antes del lunes. Las llaves están en nuestra oficina de Utrecht. Saludos, Joost Bakker
- Nota del CRM
Reunión con Sanne Vos de Hollander Bouw en Zwolle. Quiere presupuesto para 40 licencias. Seguimiento en sanne@hollanderbouw.example.
Todas las etiquetas son genéricas. No se guarda ninguna clave para volver al original.
El contexto es la parte difícil. "Nuestro director financiero" señala a una sola persona en cualquier empresa. Un cargo en un equipo de tres, una localidad junto con un suceso poco habitual o un salario citado pueden hacer lo mismo. Cuando un detalle aporta poco a un comprador, lo quitamos. Cuando importa, lo hacemos más general, por ejemplo "un directivo" en lugar de un cargo que ocupa una sola persona.
¿Qué queda fuera del conjunto de datos por completo?
Algunos datos nunca forman parte de una venta, depurados o no. El riesgo es demasiado alto o los datos no son suyos para vender.
- Datos de salud, incluidos los partes de baja y los datos médicos de los expedientes de recursos humanos
- Números de identificación nacionales, números de pasaporte e identificadores oficiales similares
- Otras categorías especiales del RGPD, como la religión, la afiliación sindical, la orientación sexual y los datos biométricos
- Datos de clientes que trata como encargado del tratamiento, por ejemplo las nóminas que gestiona para clientes o los datos que aloja para ellos
- Material amparado por el secreto profesional o confidencial de clientes, salvo que pueda depurarse por completo
Las profesiones con deber de secreto necesitan un cuidado especial. Nuestra página sobre vender los datos de un despacho de abogados muestra qué entra y qué queda fuera. Las plantillas, los flujos de trabajo y el conocimiento interno suelen seguir teniendo valor sin un solo dato de clientes.
¿Cómo se anonimizan los datos de Slack, Teams o del correo?
Combinamos detección automática con revisión humana. El software encuentra a gran escala los patrones evidentes: nombres, direcciones de correo, números de teléfono, IBAN, códigos postales. Después, personas leen muestras del resultado y buscan lo que se le escapa al software, como el contexto que apunta a una persona concreta.
Slack y Teams
En los datos de chat, la identidad aparece en más sitios que el texto del mensaje. Los nombres visibles, las @menciones, los identificadores de usuario, los nombres de canal como #cliente-brightwater y los nombres de los archivos compartidos reciben el mismo tratamiento. Los emojis y las marcas de tiempo se mantienen, porque muestran cómo fluye el trabajo, pero las horas exactas pueden redondearse cuando identificarían a alguien. Nuestra página sobre vender datos de Slack, Teams y Jira explica lo que aprenden los laboratorios de cada herramienta.
Correo electrónico
El correo esconde identificadores en los encabezados, las firmas, los avisos legales al pie y las largas cadenas de respuestas citadas. Depuramos las líneas De, Para y CC, quitamos firmas y pies, y tratamos cada respuesta citada como texto que hay que volver a depurar. Un nombre eliminado al principio de un hilo no debe sobrevivir en un mensaje citado al final.
Tickets, CRM y documentos
Los tickets y las notas del CRM están llenos de nombres de clientes, números de cuenta y datos de contacto. Los documentos añaden encabezados, campos de autor y metadatos de archivo. Depuramos el texto visible y los metadatos, porque el campo de autor de un archivo puede nombrar a una persona igual que su primera línea.
- Acordamos por escrito qué fuentes entran y cuáles quedan fuera.
- La detección automática etiqueta los identificadores en todo el conjunto.
- Los elementos etiquetados se sustituyen por etiquetas de tipo como [NOMBRE] o [IBAN].
- Los revisores leen muestras y buscan contexto revelador.
- Lo que encuentran se corrige en todo el conjunto, no solo en la muestra.
¿Se pueden reidentificar los datos anonimizados?
Los datos mal anonimizados, sí. Los datos bien anonimizados no deberían poder reidentificarse. El Grupo de Trabajo del Artículo 29, donde colaboraban las autoridades de protección de datos de la UE, describió en su Dictamen 05/2014 sobre técnicas de anonimización tres formas en que puede fallar: singularizar a una persona, vincular registros sobre la misma persona e inferir datos sobre una persona a partir de otros detalles.
Nuestros pasos responden a esos tres riesgos. Las etiquetas genéricas impiden la vinculación, porque todos los nombres parecen iguales. Eliminar el contexto revelador impide la singularización. Dejar fuera los datos de salud y otras categorías especiales limita lo que alguien podría inferir.
Lo que más importa es la clave. Si existiera una lista que relacionara las etiquetas con los nombres reales, cualquiera que la consiguiera podría deshacer el trabajo. Así que nunca la creamos. Nadie la tiene: ni nosotros, ni usted, ni el comprador. Una vez borrados los originales, no queda nada con lo que cotejar.
Ningún método es perfecto, y preferimos decirlo. Por eso una persona revisa el resultado, por eso usted revisa una muestra y por eso solo cedemos licencias a laboratorios de IA y equipos de investigación bajo contrato. No se publica nada.
¿Qué revisa usted antes de que se venda nada?
Usted revisa una muestra depurada y da el visto bueno. No se vende nada sin esa aprobación. Los pasos siguientes son el final de cómo funciona una venta, desde la entrega hasta el pago.
- Entrega segura: acceso cifrado y de solo lectura a las fuentes que usted aprueba, con acuerdo de confidencialidad desde el primer día.
- Nosotros depuramos: los nombres, los datos de clientes y otros identificadores se eliminan durante el procesamiento.
- Usted aprueba: lee una muestra depurada. Si ve algo, lo corregimos en todo el conjunto y usted vuelve a revisarlo.
- Originales borrados: una vez terminado el procesamiento, borramos nuestra copia de sus originales. Los suyos siguen donde estaban.
- Pago: el dinero está en su cuenta en un plazo de 7 días después de que los datos superen la revisión.
Los compradores solo ven muestras censuradas. El paquete completo se entrega después de que paguen. Nunca cedemos licencias a su competencia.
La anonimización no acaba con el valor. Los laboratorios quieren el razonamiento, el ir y venir y las decisiones, no los nombres. Los datos de una empresa pueden alcanzar €10K–€600K, y los conjuntos de datos más grandes o especializados pueden llegar a cientos de miles de euros. Nuestra página sobre por qué los datos de empresa valen dinero explica qué determina el precio.
¿Hay que informar a los empleados?
Sí. El conjunto de datos final está anonimizado, pero el proceso de elaborarlo no. Para depurar sus mensajes, alguien tiene que tratarlos mientras todavía contienen nombres. Ese paso es un tratamiento de datos personales según el RGPD, y el Dictamen 05/2014 citado arriba dice lo mismo: la anonimización es en sí misma un tratamiento posterior.
Los datos anonimizados quedan fuera del RGPD. El proceso de anonimizarlos, no.
En la práctica, eso supone tres cosas por su parte. Necesita una evaluación documentada: una prueba de compatibilidad para la nueva finalidad, normalmente una evaluación del interés legítimo y a menudo una EIPD. Necesita transparencia: una política de privacidad actualizada que informe a la plantilla y a los contactos de que pueden cederse bajo licencia copias desidentificadas para entrenar IA, con una forma sencilla de oponerse. Y si tiene comité de empresa, implíquelo pronto.
Nuestra guía sobre si es legal vender datos de empresa según el RGPD recorre cada paso con una lista de comprobación. El alcance y las condiciones que firmamos con usted también le dan un registro para sus propios archivos.
Preguntas
¿Siguen siendo datos personales los datos anonimizados según el RGPD?
No, si son realmente anónimos. El considerando 26 del RGPD dice que las normas no se aplican a los datos en los que una persona ya no es identificable por ningún medio que razonablemente pueda utilizarse. Los datos seudonimizados, en los que todavía existe una clave, siguen siendo datos personales.
¿Qué diferencia hay entre datos anonimizados y datos anónimos?
En la práctica, ninguna. Ambos términos describen datos que ya no pueden vincularse a una persona. Anonimizados subraya que se ha llegado a ese punto eliminando los identificadores de datos que antes eran personales.
¿Guardan una clave para poder rastrear los datos si hace falta?
No. Sustituimos los identificadores por etiquetas genéricas como [NOMBRE] y nunca creamos una lista que relacione las etiquetas con las personas. Guardar una lista así haría que los datos fueran seudonimizados y, por tanto, seguirían siendo datos personales.
¿Puedo ver cómo quedan mis datos después de la depuración?
Sí. Usted revisa una muestra depurada antes de que se venda nada, y nada sigue adelante sin su visto bueno. Si ve algo, lo corregimos en todo el conjunto.
¿Qué pasa con mis datos originales?
Los conserva y los sigue usando, porque cede una copia bajo licencia. Nuestra copia de los originales se borra una vez terminado el procesamiento.
¿Se incluyen alguna vez datos médicos o de recursos humanos?
Los datos de salud, los números de identificación nacionales y otras categorías especiales quedan fuera por completo. Los expedientes de recursos humanos con ese tipo de información se excluyen; no se depuran para venderlos.
¿La anonimización hace que los datos no valgan nada para los laboratorios de IA?
No. Los laboratorios entrenan con cómo se hace el trabajo: las preguntas, el razonamiento y las decisiones. Los nombres y los números de teléfono no aportan nada a eso, así que quitarlos resta muy poco valor.
¿Quién compra los datos anonimizados?
Laboratorios de IA y equipos de investigación que entrenan y evalúan modelos, bajo contrato. Nunca cedemos licencias a su competencia y no se publica nada.
Esta información es de carácter general y no constituye asesoramiento jurídico.