Vad innebär det att sälja anonymiserad företagsdata?
Det innebär att en köpare får innehållet i ert arbete men ingen av personerna i det. Ett AI-labb lär sig hur ditt team hanterar ett klagomål, avgränsar ett projekt eller rättar en bugg. Det får aldrig veta vem som skrev meddelandet, vilken kund det gällde eller hur man når någon.
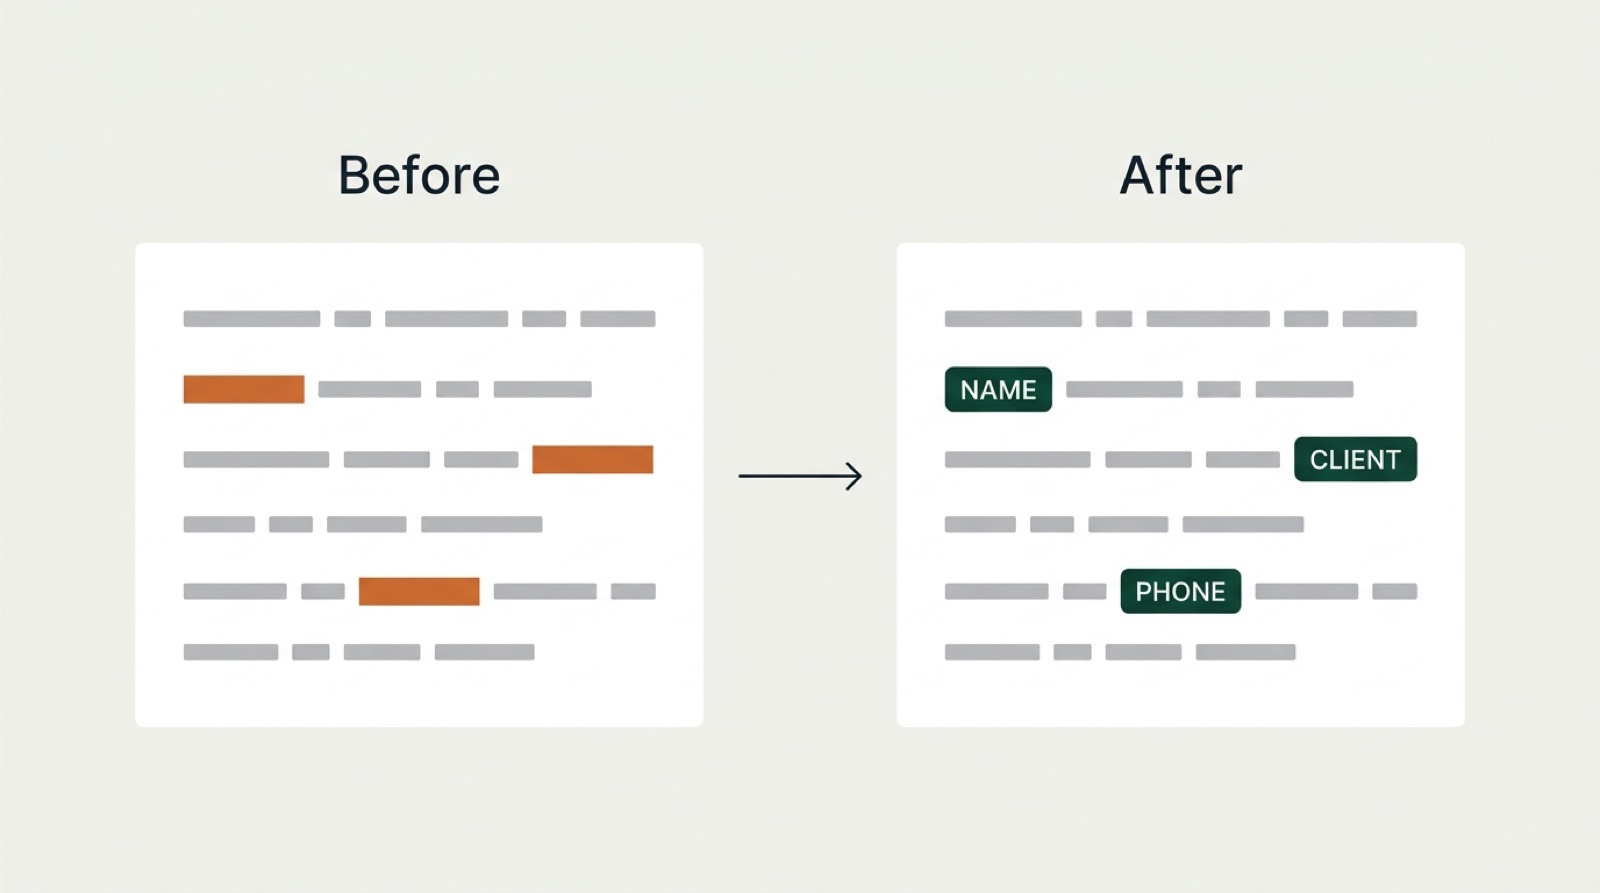
Vi köper sådan data från företag med ungefär 10 personer och uppåt: meddelanden i Slack och Teams, e-post, dokument, ärenden, poster i CRM, kod och rutiner. Vi rensar den och licensierar den sedan till AI-labb som tränar och testar modeller. Du behåller dina original och fortsätter använda dem. Du licensierar en kopia.
Vårt löfte är enkelt: det vi levererar är helt anonymiserat. Det löftet betyder bara något om det backas upp av konkreta steg. Den här sidan listar dem, och den säger också rakt ut var GDPR fortfarande gäller för dig.
Vad är anonymiserade uppgifter enligt GDPR?
Anonymiserade uppgifter är information som inte längre avser en identifierad eller identifierbar person. GDPR gäller inte för dem. Regeln finns i skäl 26 i GDPR, som säger att principerna för dataskydd inte bör gälla uppgifter som har anonymiserats så att personen inte längre är identifierbar. På engelska skrivs samma sak anonymised eller, med amerikansk stavning, anonymized data.
Prövningen är sträng. Skäl 26 frågar om någon skulle kunna identifiera en person med alla hjälpmedel som rimligen kan komma att användas, av dig eller av någon annan. Kostnad, tid och tillgänglig teknik nämns som faktorer. Det räcker inte att ta bort ett namn om resten av underlaget ändå avslöjar personen.
Anonymisering
Anonymisering är processen där personuppgifter görs om till anonymiserade uppgifter, för gott. Ingen, inte vi och inte du, kan efteråt spåra ett underlag tillbaka till en person. Resultatet faller utanför GDPR.
Pseudonymisering
Pseudonymisering definieras i artikel 4.5 i GDPR. Det innebär att uppgifter behandlas så att de inte längre kan kopplas till en person utan kompletterande uppgifter, som förvaras separat och skyddas. Att byta "Anna de Vries" mot "Anställd 0042" och spara listan som kopplar det ena till det andra är pseudonymisering.
Skäl 26 är tydligt med att pseudonymiserade uppgifter fortfarande är personuppgifter, eftersom de kan kopplas tillbaka med de kompletterande uppgifterna. Därför sparar vi ingen lista, ingen uppslagstabell och ingen koppling av något slag.
Anonymisering eller pseudonymisering: vad är skillnaden?
Skillnaden är nyckeln. Pseudonymiserade uppgifter har en, någonstans. Anonymiserade uppgifter har ingen, någonstans. Allt annat följer av det.
| Vad som sparas | Kan de kopplas tillbaka? | Status enligt GDPR | |
|---|---|---|---|
| Rådata | Allt: namn, e-postadresser, telefonnummer, kundnamn, IBAN-nummer, adresser | Ja, personerna nämns redan vid namn | Personuppgifter |
| Pseudonymiserade | Texten, med namn utbytta mot koder eller tokens | Ja, av den som har nyckeln | Fortfarande personuppgifter (skäl 26, artikel 4.5) |
| Helt anonymiserade (det vi levererar) | Texten, med identifierare ersatta av typetiketter som [NAMN] eller [KUND] | Nej. Ingen nyckel sparas av någon och avslöjande sammanhang tas bort | Utanför GDPR när ingen rimligen kan identifiera en person (skäl 26) |
Ett praktiskt exempel: i en pseudonymiserad fil förekommer "Anställd 0042" i 300 meddelanden, så en läsare kan följa en person genom hela arkivet. I våra filer blir varje namn samma etikett, [NAMN]. Samtalet är fortfarande begripligt, men det finns ingen tråd att dra i.
Pseudonymiserade uppgifter har en nyckel någonstans. Helt anonymiserade uppgifter har ingen nyckel någonstans.
Vad tar vi bort innan data säljs?
Vi tar bort varje direkt identifierare och sedan det sammanhang som skulle kunna peka ut en enskild person. Den första delen är mekanisk. Den andra kräver omdöme.
- Namn på anställda, kunder, leverantörer och kontaktpersoner, inklusive smeknamn och @omnämnanden
- E-postadresser, telefonnummer och postadresser
- Namn på kund- och leverantörsföretag
- Bankkonto- och IBAN-nummer samt faktura- och avtalsnummer som leder till ett konto
- Kundnummer, användar-id, registreringsnummer och andra identifierande nummer
- Signaturer, sidfötter i mejl och profiluppgifter
- Sammanhang som pekar ut en enskild person, som "vår enda skattejurist i Leeds" eller datumet för någons sjukskrivning
Varje uppgift ersätts av en etikett för sin typ, så att texten behåller sin form. Exemplen nedan visar hur det ser ut på vardagliga underlag.
- Slack, #sälj
Anouk, kan du ringa Pieter Verbeek på Brightwater Foods före fredag? Direktnummer: +31 6 12345678. De vill ha förra årets pris.
- Ärende i Jira
Fakturaexporten misslyckas för Kroonstad Logistics. Rapporterat av Tom de Wit, kontakt l.jansen@kroonstad.example. Återskapat i testmiljön.
- E-post
Hej Marieke, betala in depositionen till NL00 BANK 0123 4567 89 senast måndag. Nycklarna finns på vårt kontor i Utrecht. Hälsningar, Joost Bakker
- Anteckning i CRM
Träffade Sanne Vos från Hollander Bouw i Zwolle. Vill ha en offert på 40 licenser. Följ upp via sanne@hollanderbouw.example.
Varje etikett är allmän. Ingen nyckel tillbaka till originalet sparas.
Sammanhanget är den svåra delen. "Vår ekonomichef" pekar ut en person i vilket företag som helst. En yrkestitel i ett team på tre, en ort i kombination med en ovanlig händelse eller en angiven lön kan göra detsamma. Där en uppgift tillför lite för en köpare stryker vi den. Där den spelar roll gör vi den mer allmän, till exempel "en ledande befattningshavare" i stället för en titel som bara en person har.
Vad hålls helt utanför datasetet?
Viss data ingår aldrig i en försäljning, rensad eller inte. Risken är för hög eller så är datan inte din att sälja.
- Hälsouppgifter, inklusive sjukintyg och medicinska uppgifter i personalakter
- Personnummer, passnummer och liknande identifierare som myndigheter utfärdar
- Andra särskilda kategorier enligt GDPR, som religion, medlemskap i fackförening, sexuell läggning och biometriska uppgifter
- Kunddata som du behandlar som personuppgiftsbiträde, till exempel löner som du sköter åt kunder eller data som du lagrar åt kunder
- Material som omfattas av tystnadsplikt eller är klientkonfidentiellt, om det inte kan rensas helt
Yrken med tystnadsplikt behöver vara extra noga. Vår sida om att sälja data från en advokatbyrå visar vad som ingår och vad som hålls utanför. Mallar, arbetsflöden och intern know-how är oftast värdefulla även utan en enda klientuppgift.
Hur anonymiserar man data från Slack, Teams eller e-post?
Vi kombinerar automatisk igenkänning med mänsklig granskning. Programvara hittar de uppenbara mönstren i stor skala: namn, e-postadresser, telefonnummer, IBAN-nummer, postnummer. Sedan läser människor urval av resultatet och letar efter det som programvaran missar, till exempel sammanhang som pekar ut en enskild person.
Slack och Teams
Chattdata bär på identitet på fler ställen än i själva meddelandetexten. Visningsnamn, @omnämnanden, användar-id, kanalnamn som #kund-brightwater och namn på delade filer behandlas på samma sätt. Emojier och tidsstämplar får vara kvar, eftersom de visar hur arbetet flyter, men exakta klockslag kan göras grövre där de skulle kunna identifiera någon. Vår sida om att sälja data från Slack, Teams och Jira förklarar vad labben lär sig av varje verktyg.
E-post
E-post gömmer identifierare i rubrikfält, signaturer, juridiska sidfötter och långa kedjor av citerade svar. Vi rensar raderna Från, Till och Kopia, tar bort signaturer och sidfötter och behandlar varje citerat svar som text som ska rensas på nytt. Ett namn som har tagits bort högst upp i en tråd får inte överleva i ett citerat meddelande längst ner.
Ärenden, CRM och dokument
Ärenden och anteckningar i CRM är fulla av kundnamn, kontonummer och kontaktuppgifter. Dokument tillför sidhuvuden, författarfält och filmetadata. Vi rensar den synliga texten och metadatan, eftersom en fils författarfält kan namnge en person lika väl som dess första rad.
- Vi kommer skriftligt överens om vilka källor som ingår och vilka som hålls utanför.
- Automatisk igenkänning märker identifierare i hela datamängden.
- Märkta uppgifter ersätts av typetiketter som [NAMN] eller [IBAN].
- Granskare läser urval och letar efter avslöjande sammanhang.
- Det de hittar rättas i hela datamängden, inte bara i urvalet.
Kan anonymiserad data återidentifieras?
Dåligt anonymiserad data kan det. Väl anonymiserad data ska inte kunna det. Artikel 29-gruppen, där EU:s dataskyddsmyndigheter samarbetade, beskrev tre sätt som det kan gå fel på i sitt yttrande 05/2014 om anonymiseringstekniker: att peka ut en enskild person, att koppla samman underlag om samma person och att dra slutsatser om en person utifrån andra uppgifter.
Våra steg motsvarar de tre riskerna. Allmänna etiketter förhindrar sammankoppling, eftersom varje namn ser likadant ut. Att ta bort avslöjande sammanhang förhindrar utpekande. Att hålla hälsouppgifter och andra särskilda kategorier utanför begränsar vad någon skulle kunna sluta sig till.
Nyckeln spelar störst roll. Om det fanns en lista som kopplade etiketterna till verkliga namn skulle den som fick tag på den kunna göra arbetet ogjort. Därför skapar vi aldrig någon. Ingen har den: inte vi, inte du, inte köparen. När originalen väl är raderade finns det inget kvar att matcha mot.
Ingen metod är perfekt, och det säger vi hellre öppet. Det är därför en människa granskar resultatet, därför du kontrollerar ett urval och därför vi bara licensierar till AI-labb och forskningsteam under avtal. Ingenting publiceras.
Vad kontrollerar du innan något säljs?
Du kontrollerar ett rensat urval och godkänner det. Utan det godkännandet säljs ingenting. Stegen nedan är slutet på hur en försäljning går till, från överlämning till betalning.
- Säker överlämning: krypterad läsbehörighet till de källor du godkänner, under sekretessavtal från första dagen.
- Vi rensar: namn, kunduppgifter och andra identifierare tas bort under bearbetningen.
- Du godkänner: du läser ett rensat urval. Om du hittar något rättar vi det i hela datamängden och du kontrollerar igen.
- Originalen raderas: när bearbetningen är klar raderar vi vår kopia av dina original. Dina egna ligger kvar där de var.
- Betalt: pengarna finns på ditt konto inom 7 dagar efter att datan har klarat granskningen.
Köpare ser bara maskerade urval. Hela paketet lämnas ut efter att de har betalat. Vi licensierar aldrig till dina konkurrenter.
Anonymiseringen tar inte bort värdet. Labben vill ha resonemangen, diskussionerna och besluten, inte namnen. Företagsdata kan ge €10K–€600K, och större eller mer specialiserade dataset kan ge upp till flera hundra tusen euro. Vår sida om varför företagsdata är värd pengar förklarar vad som styr priset.
Måste de anställda informeras?
Ja. Det färdiga datasetet är anonymiserat, men framtagandet av det är inte det. För att rensa era meddelanden måste någon behandla dem medan de fortfarande innehåller namn. Det steget är behandling av personuppgifter enligt GDPR, och yttrande 05/2014 ovan säger detsamma: anonymisering är i sig en vidare behandling.
Anonymiserade uppgifter faller utanför GDPR. Att ta fram dem gör det inte.
I praktiken innebär det tre saker på din sida. Du behöver en dokumenterad bedömning: en prövning av om det nya ändamålet är förenligt, oftast en intresseavvägning för berättigat intresse och ofta en DPIA. Du behöver öppenhet: en uppdaterad integritetspolicy som talar om för personal och kontakter att avidentifierade kopior kan licensieras för AI-träning, med ett enkelt sätt att invända. Och om ni har ett företagsråd, involvera det tidigt.
Vår guide om huruvida det är lagligt att sälja företagsdata enligt GDPR går igenom varje steg med en checklista. Omfattningen och villkoren som vi skriver under med dig ger dig också dokumentation för dina egna arkiv.
Frågor
Är anonymiserade uppgifter fortfarande personuppgifter enligt GDPR?
Inte om de verkligen är anonyma. Skäl 26 i GDPR säger att reglerna inte gäller uppgifter där en person inte längre är identifierbar med något hjälpmedel som rimligen kan komma att användas. Pseudonymiserade uppgifter, där det fortfarande finns en nyckel, är fortfarande personuppgifter.
Vad är skillnaden mellan anonymised och anonymized data?
Ingen. Anonymised är brittisk stavning och anonymized amerikansk. Båda betyder det som på svenska kallas anonymiserade uppgifter: data som inte längre kan kopplas till en person.
Sparar ni en nyckel så att ni kan spåra data tillbaka vid behov?
Nej. Vi ersätter identifierare med allmänna etiketter som [NAMN] och skapar aldrig en lista som kopplar etiketter till personer. Om vi sparade en sådan lista skulle datan vara pseudonymiserad, och därmed fortfarande personuppgifter.
Kan jag se hur min data ser ut efter rensningen?
Ja. Du kontrollerar ett rensat urval innan något säljs, och ingenting går vidare utan ditt godkännande. Om du hittar något rättar vi det i hela datamängden.
Vad händer med min ursprungliga data?
Du behåller den och fortsätter använda den, eftersom du licensierar en kopia. Vår kopia av originalen raderas så snart bearbetningen är klar.
Ingår medicinska uppgifter eller personaluppgifter någonsin?
Hälsouppgifter, personnummer och andra särskilda kategorier hålls helt utanför. Personalakter med den sortens uppgifter undantas, de rensas inte och säljs inte.
Gör anonymiseringen datan värdelös för AI-labb?
Nej. Labben tränar på hur arbete blir gjort: frågorna, resonemangen och besluten. Namn och telefonnummer tillför ingenting till det, så att ta bort dem kostar väldigt lite av värdet.
Vem köper den anonymiserade datan?
AI-labb och forskningsteam som tränar och testar modeller, under avtal. Vi licensierar aldrig till dina konkurrenter och ingenting publiceras.
Det här är allmän information, inte juridisk rådgivning.